
前言:代理隧道流量伪装得像不像,肉眼说了不算。本文用tshark加纯Python搭建自动化抓包对比流水线,从TCP协议栈指纹、JA3/TLS指纹、包长分布JSD与KS检验、时序自相关四个维度量化隧道流量与真实HTTPS的统计差异,低于阈值直接FAIL并接入CI门禁,让流量伪装从玄学变成可回归的工程。
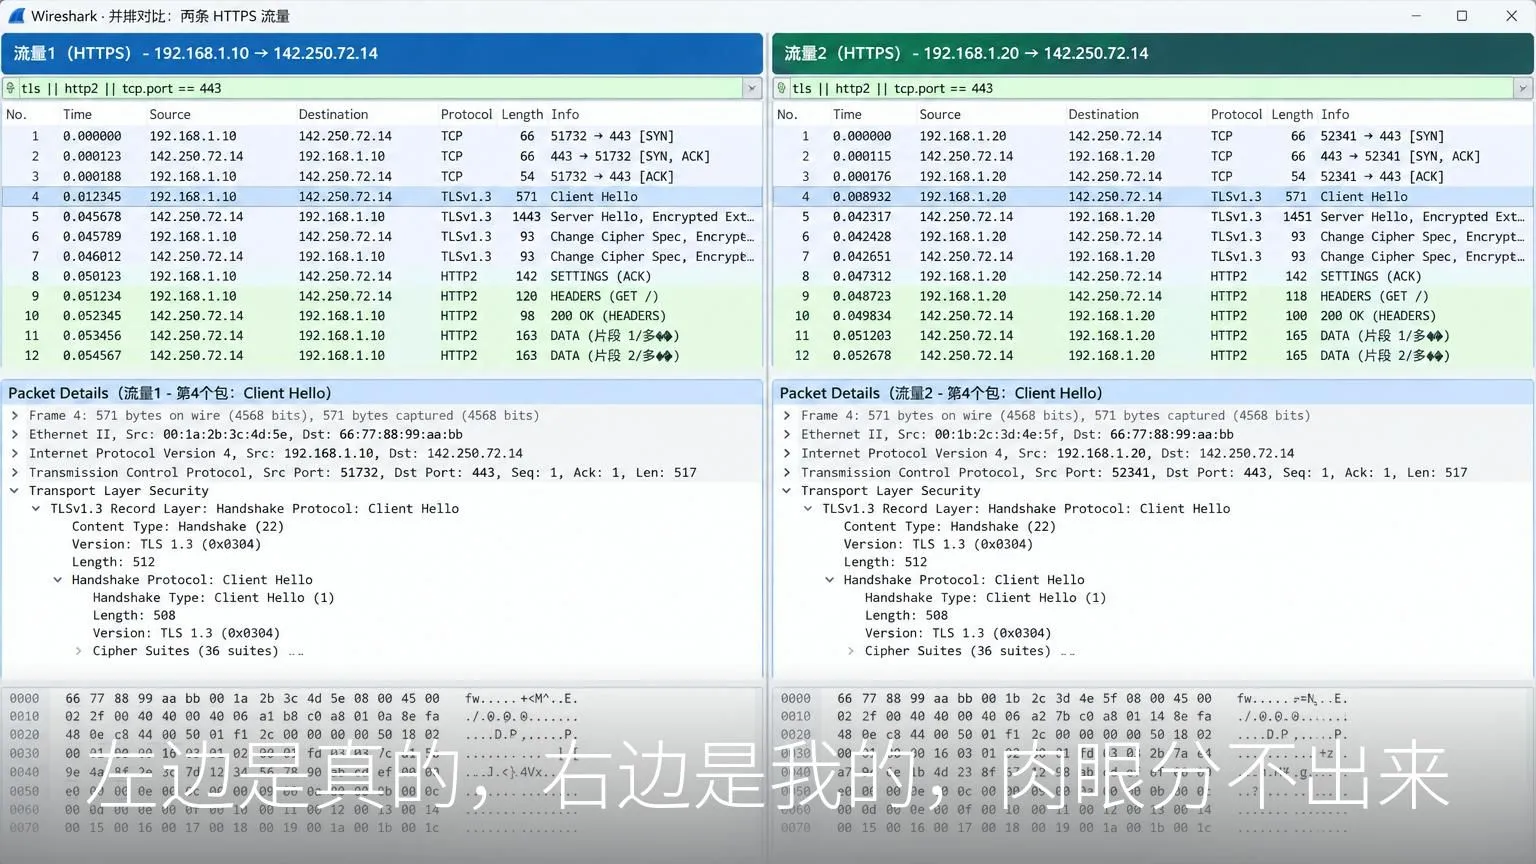
前几天晚上,我把两个抓包文件并排放在一起看。
左边那条,是真的 Chrome 在加载一个网页。右边那条,是我最近在搞的代理项目 PX/2 走隧道的流量。肉眼看,都是密密麻麻的 TLS 包,都是 443 端口,都长得人畜无害。
但说实话,我心里没底。
因为「长得像」这三个字,在流量伪装这件事里,是最不值钱的评价。审查设备不看长相,它看统计特征。你的包长分布,你的包间隔时间,你 TCP 握手那一瞬间报出来的那串参数。这些东西,肉眼骗得过,数学骗不过。
所以我干了件笨事。花了一阵子,搞了一套自动化的抓包对比流水线,tshark 加纯 Python 标准库,零第三方依赖,把「我的流量像不像真的 HTTPS」从一句玄学,变成四个可以打分的数字,低于分数线直接 FAIL,拦在代码合并之前。
这篇文章,就是把这套压箱底的东西掏出来。先说好,阈值什么的我自己也还在调,你拿去当个起点,别照抄。
先交代点背景,聊天式的,不吓人。
审查设备做被动检测的时候,是不解密的,TLS 1.3 的密文它啃不动。但它也不需要啃动,它站在旁边看,看四个维度。
第一层,IP 和 TCP 的协议栈指纹。你的 TTL 是多少,DF 标志位有没有开,TCP 窗口多大,MSS 多少,TCP Options 的排列顺序是什么样。这些东西由操作系统内核决定,你应用层装得再像,内核会说实话。
第二层,TLS 握手本身。ClientHello 里的套件顺序、扩展列表,业内管这个叫 JA3/JA4 指纹。Go 标准库的 crypto/tls 有个著名的问题,就是所有 Go 写的程序握手起来长得一模一样,跟 Chrome 那种千人千面的画像完全对不上。
第三层,包长分布。真实网页加载是「一堆小包请求,一大串满载包响应」,如果你的隧道因为固定头部开销,包长老是在某个奇怪的字节数上冒尖,那在直方图上就是一个醒目的 Spike,等于自己举手报告。
第四层,时序。真实流量是乱的,机械的心跳是准的。固定每 30 秒发一个 keepalive,在自相关分析里就是一根笔直的周期尖峰,也是自己举手报告。
这四层,就是我的流水线要逐一对比的东西。思路很简单,抓两份包,一份真的,一份我的,同一个维度用同一个算法去算,差距小于阈值就 PASS,大了就 FAIL。
下面一条条说怎么做。
1、先抓两份「同源」的包,这一步偷懒,后面全白搭
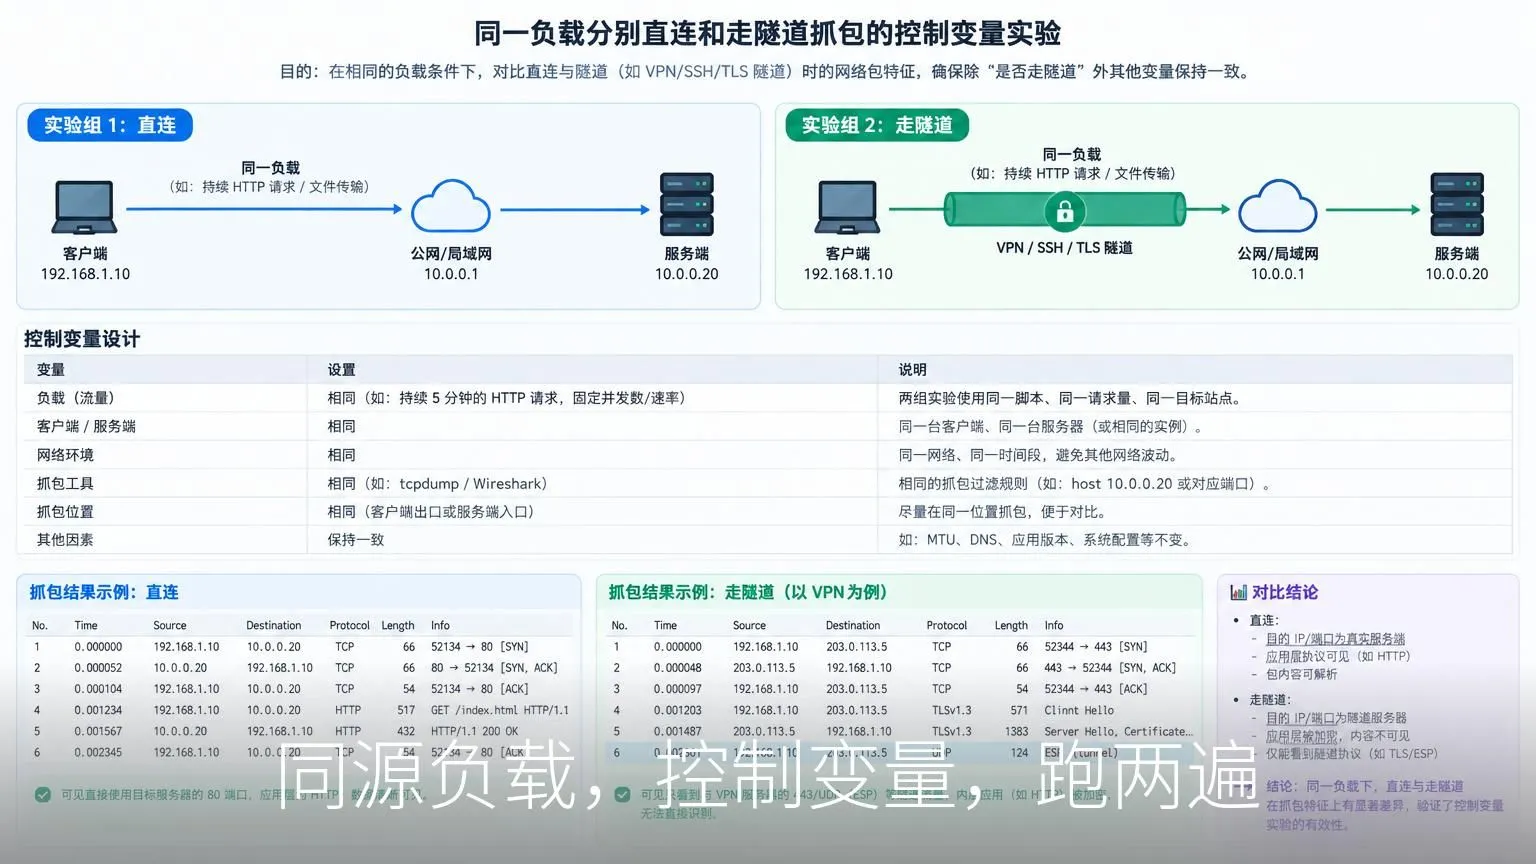
最容易犯的错误,是拿自己平时刷网页的流量当基线,再拿工具跑测速的流量当候选。负载都不一样,比出来的分布差异全是负载带来的,跟伪装好不好没有半毛钱关系。
所以必须控制变量。同一台机器,同样的操作脚本,跑两遍。一遍直连目标站,存成 baseline。一遍走 PX/2 隧道,存成 candidate。抓包命令就一行。
tshark -i eth0 -f "tcp port 443" -w baseline.pcapng
负载要准备三种。一种是交互式的,模拟浏览器拉 HTML、CSS 和 JSON 接口,考验小包填充。一种是拉个 5 到 10MB 的大文件,考验满载吞吐的形态和分片。还有一种是啥也不干,连接空闲挂着 60 秒,专门考验掩护流会不会暴露机械周期。
三种负载,三组对照。别嫌麻烦,静默那组是最容易抓出问题的,我的掩护流就是在那组里第一次露馅的。
2、TCP 握手那一下,是最容易穿帮的地方
这里有个特别经典的跨层冲突。你的 TLS 层用 uTLS 把 ClientHello 伪装成 Chrome on Windows,天衣无缝。但你的 TCP SYN 包里,带着 Linux 才有的 Timestamp 选项,TTL 还是 64。
等于一个老外中文说得字正腔圆,一掏护照,国籍那栏露馅了。
所以第一组检查,就是把两边的 SYN 包提出来,编成一个标准化的签名,窗口大小、Options 种类和顺序、MSS、窗口缩放因子,拼成一串。比如 Windows 11 的典型签名长这样,64240_2-1-3-1-1-4_1460_8。两边的签名必须完全一致,不一致就是 FAIL,没有 WARN 的余地,因为 Options 顺序这种东西没有「差不多」一说。
顺带查两个便宜指标。一个是 TTL,Windows 出厂 128,Linux 和 macOS 是 64,得跟你声明的画像对上。另一个是 DF 标志位,现代主流系统在 TCP 上默认全开,两边占比差异超过 5%,就该回去翻代码了。
3、TLS 这层,重点看两个熵
JA3 指纹对齐是基本功。把 ClientHello 解出来,套件和扩展列表跟基线比对,GREASE 那些随机值过滤掉再比,别被它干扰。这块现成的解析脚本就能干,不展开。
真正有意思的是熵。
第一个熵,SessionID 的。ClientHello 里那个 32 字节的 SessionID,如果里面藏了自定义协议的信息(我们管它叫 KIP),它必须是高熵的密文。32 个字节的小样本,信息熵的理论上限是 5.0 bits/byte,单包算出来得大于等于 4.5 才算合格。要是算出来 3 点几,或者开头几个字节永远是固定的,那等于把暗号写在脑门上。
第二个熵,握手完成之后的载荷。真实 TLS 1.3 密文的信息熵在 7.95 到 8.0 之间,顶到天花板。你的隧道流量算出来低于 7.85,说明里面混了明文,或者填充字节是重复的。这个指标便宜好用,一行 Shannon 公式的事,但抓低级错误特别灵。
4、包长分布,JSD 和 KS 上双保险
这块是重头戏。把有效载荷的包长按 64B 和 128B 分桶,归一化成概率分布,基线一份,候选一份,算 Jensen-Shannon 散度。这个数取值 0 到 1,越小越像。我的及格线定在 0.08,超过 0.15 直接 FAIL,说明分布已经偏到肉眼可见的地步了。
那 JSD 一项就够了吗?还真不够。
分桶是有边界的。如果你的隧道有个固定 17 字节的头部开销,所有包整体右移了一点,可能刚好每桶都挪了一点点,JSD 看着还行。所以要再上一个不分桶的 KS 统计量,直接比两条经验累积分布曲线的最大垂直距离,任何系统性的偏移都逃不掉。
还有一个单点尖峰检测,特别朴素。非满载的包里,如果某个精确的包长占了总包数的 25% 以上,而基线里没有这个现象,那基本就是某个固定尺寸的控制帧忘了加随机填充。这个检查帮我抓出过好几次心跳帧,属于性价比之王。
5、时序,心跳是伪装协议的头号杀手
前面三层都过了,很多协议还是死在这。。。
检测方法不复杂。把空闲阶段的包间隔提出来,算变异系数,就是标准差除以均值。真实的网络抖动,这个值不会太小。如果你的掩护流是固定定时器驱动的,间隔几乎恒定,变异系数趋近 0,那在审查设备的频谱分析里就是一根笔直的针。
我的要求是长间隔样本的变异系数大于等于 0.2,再算一下滞后 1 到 10 的自相关,不能出现超过 0.6 的周期峰。做不到,就给定时器加随机抖动,范围宁可放大一点。
最后顺手再比一个上下行字节比。真实网页加载是请求小包突发、响应大包洪流,方向比是有形状的。如果两条流量的形状对不上,前面全过了也值得回头看看。
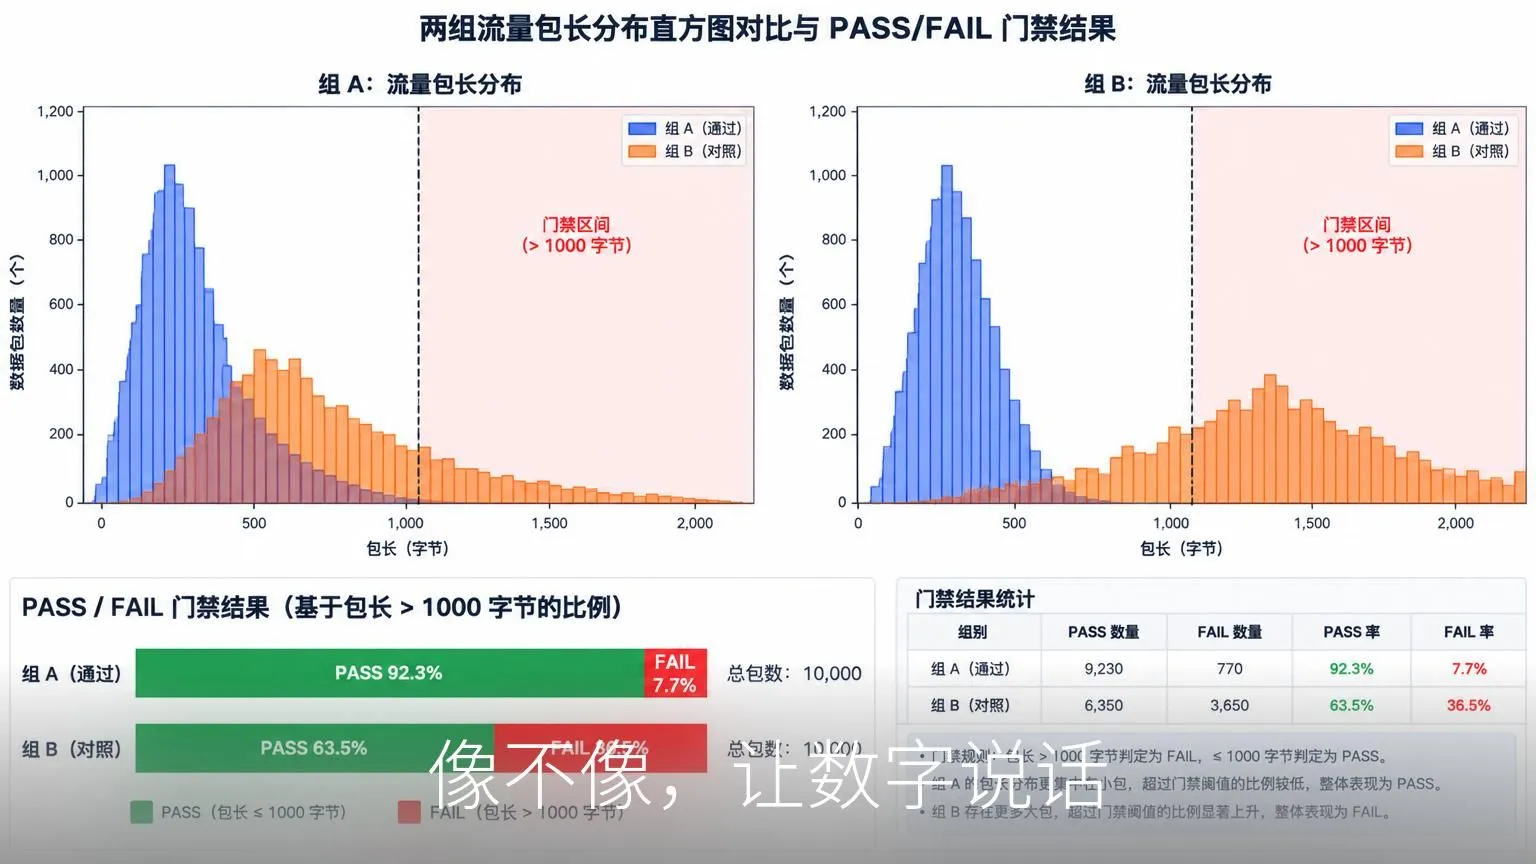
全部算完,每个检查项给出 PASS、WARN 或者 FAIL,落成一份 Markdown 报告加一份 JSON。JSON 那份是给 CI 用的,接进流水线,每次改动跑一遍,哪次把相似度改退化 了,门禁直接拦下来,不用等到上线之后靠自信硬撑。
最后说点题外话。
二战的时候有个荷兰画家叫范米格伦,伪造维米尔伪造到以假乱真,专家团鉴定全部通过。后来他为了自证清白,当庭画了一幅「新维米尔」,才算洗脱嫌疑。有意思的地方在于,他后来说,伪造比原创累多了。
流量伪装这件事一模一样。原创一个协议很容易,让它在每一个统计维度上都不可区分,是难上一个数量级的活。但难,不代表没法度量。把「像不像」拆成 TTL、指纹、熵、分布、周期这一个个具体的数字,事情就从艺术变的一门工程。
而工程的意思是,它可以被自动化,可以被回归,可以每天晚上自己检查自己有没有穿帮。
回到开头那两个并排的抓包文件。现在我不打开它们了,跑一遍脚本,看四个数字。
像不像,数学说了算。
/ 注意,本项目仅在 SyncMein 的500人小群分享。
/ 谢谢你看完了我的文章,我们下次再见吧。
/ 作者:明察
/ 投稿或爆料,请联系邮箱:mingcha@gqmg.com



暂无评论内容