
前言:还在为1000行客户反馈手动标注到崩溃?本文分享一个浏览器插件,基于WebGPU让15亿参数大模型在浏览器本地运行,批量处理Excel时数据全程不出电脑,断网可用,天然满足企业数据合规要求。文章还拆解了Chrome标签页节流与查杀的应对方案:静音音频保活、呼吸节律、IndexedDB断点续传,让批量任务稳定跑完不崩。
我把一个15亿参数的大模型,塞进了浏览器里
先想象一个画面。
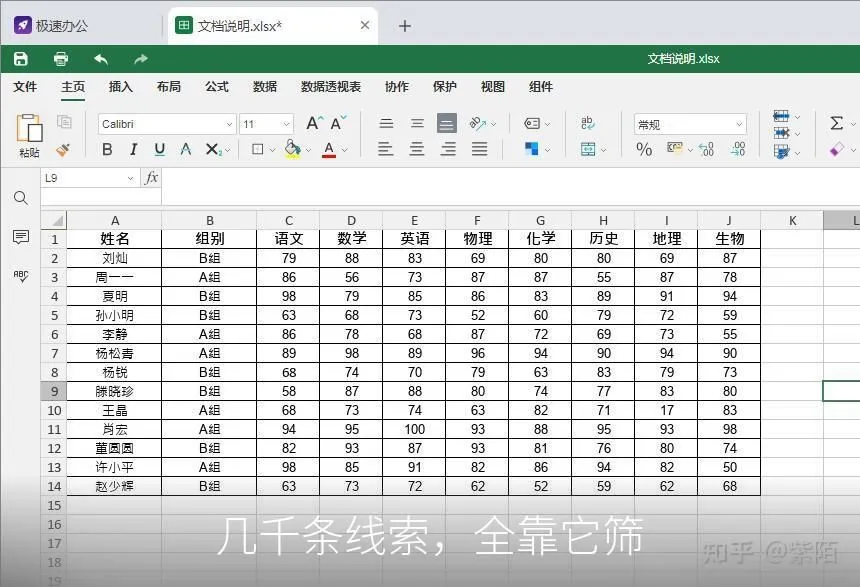
你是一家公司的行政,周五下午四点,老板甩给你一个Excel,里面是1000条客户反馈,让你把每一条标上正面还是负面,再把提到的问题拆出来,周一早上要用。
你打开网页版的AI助手,刚准备把表格粘贴进去,突然停住了。
这些反馈里有客户名字,有电话,有合同金额。传上去,合规吗?
大概率不合规。现在稍微像样点的公司,都三令五申不许把内部数据贴给公网大模型。可不用AI,1000行,一行一行手动标,标到周一也标不完。
这个死结,就是我最近在搞的东西想解的。
一个浏览器插件。对,就是那种点一下浏览器右上角小图标的玩意儿。它干的事说出来一点都不性感,批量处理Excel。但它有个特别的地方,AI模型就跑在你自己的电脑里,用的是你显卡的算力,断网都能用,数据从头到尾没离开过你的浏览器。
我知道,听到「浏览器里跑大模型」这句话,很多人的第一反应是,这能行吗?
我跟你说,真行。
这里得顺手掏点背景。有个叫MLC的团队做了个开源项目叫WebLLM,它能让大模型直接在浏览器里跑推理,靠的是一个叫WebGPU的浏览器新能力。简单讲,WebGPU就是让网页代码可以直接摸到你的显卡。Chrome从113版开始支持它,也就是说,只要你电脑上的Chrome或者Edge不是老古董,你的浏览器就已经是一台能跑AI的机器了,普通核显也行不一定非得英伟达显卡。
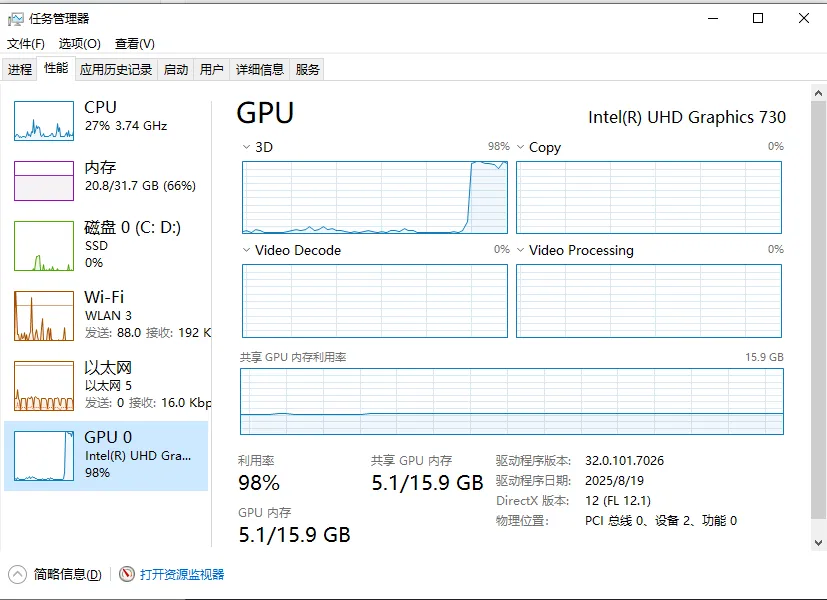
模型权重第一次会下载到浏览器的缓存里,大概1个G,之后哪怕你拔了网线,它照样能干活。整个推理过程发生在你本机的GPU上,没有一个字节流出去。
这个特性太对味了。企业数据合规这个焦虑,困扰了不知道多少公司,而答案居然是,别上传,模型自己过来。
那怎么把这个极客味十足的东西,交给一个完全不懂技术的财务或者行政?
我的思路是,技术可以复杂,但暴露给人的一定要傻瓜。
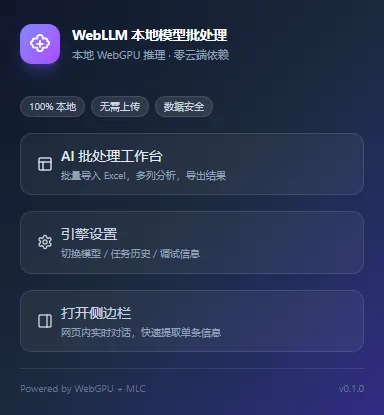
所以插件装好之后,你点开它,看到的只有一个按钮,打开AI批处理工作台。点它,会新开一个全屏的标签页,这才是真正干活的地方。为什么非要跳出去开新页面,这里头全是血泪,后面再说。
第一次进工作台,它会先做体检。显卡支不支持WebGPU,驱动新不新,一样一样查。查完了开始下载模型,界面上不会出现什么下载量化权重这种鬼话,就一句话,正在为您初始化本地AI大脑,约需几分钟,仅首次需要,之后可断网使用。
下载的这个模型,默认是Qwen2.5的1.5B版本,15.4亿参数,压完大概1个G,绝大多数办公电脑的显卡都能带得动。想上Llama-3-8B也行,但会标注一句,需要高性能独立显卡,别为难你的核显。
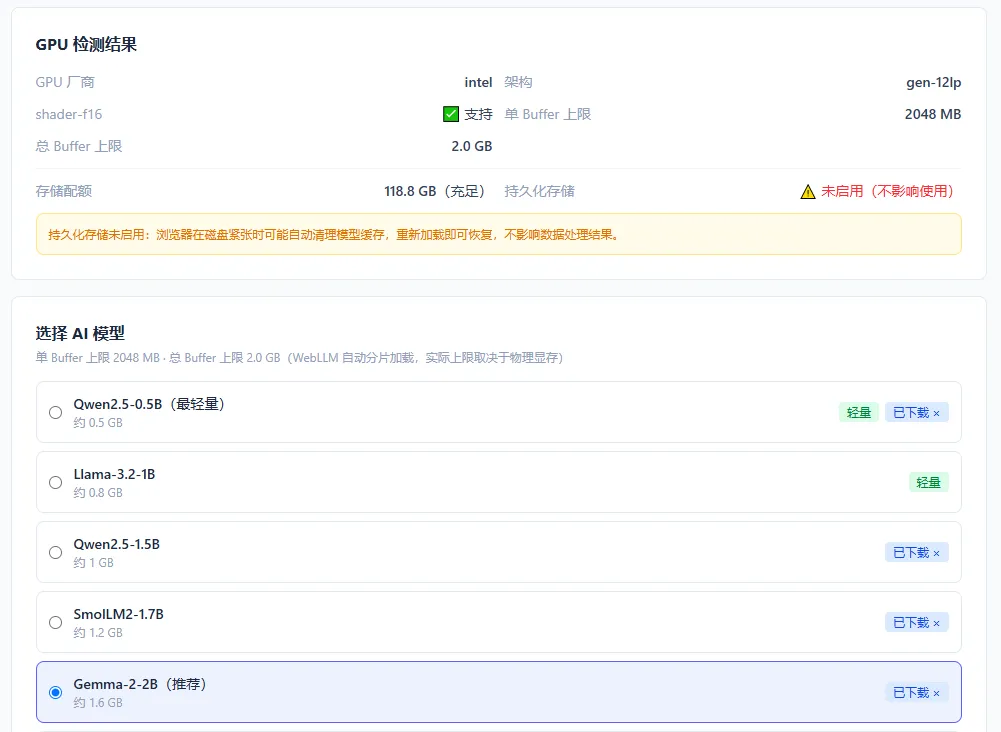
然后就是拖文件。把Excel或者CSV往页面里一丢,瞬间解析出预览,前3行数据摆在下面,你自己确认没乱码。选一列,比如客户反馈,再在一个填空框里写你要干什么,判断情感是正面还是负面。就这一句,不用懂什么叫Prompt拼接,不用懂什么叫System Prompt。
点开始。
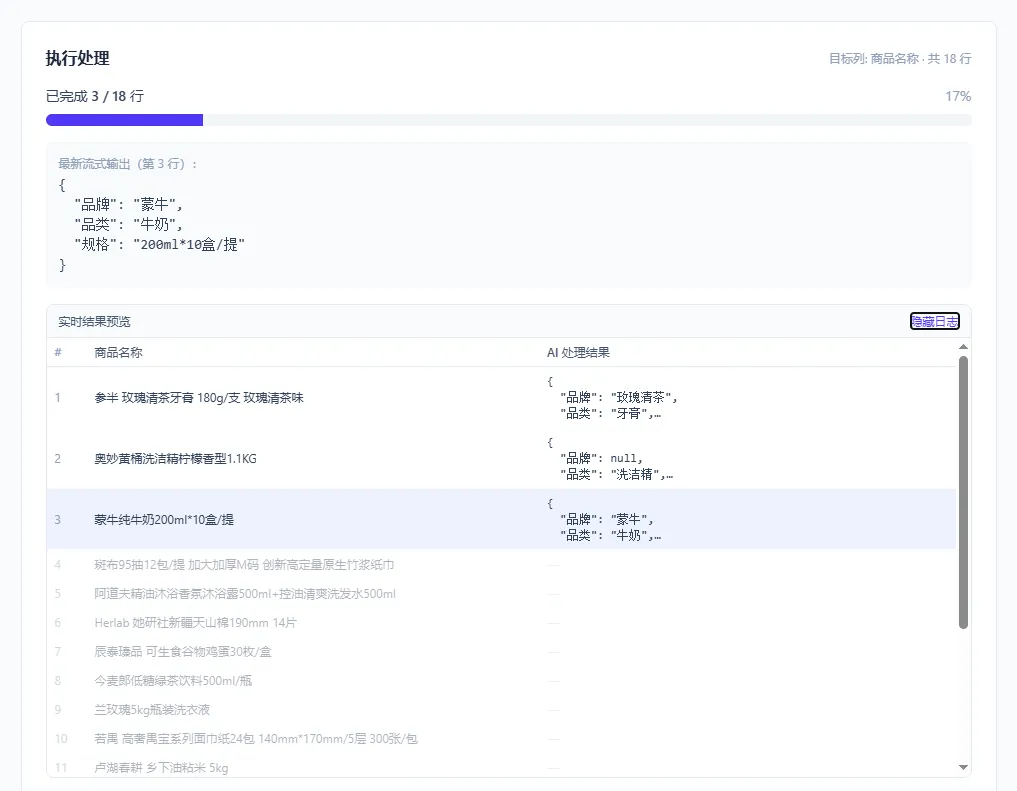
接下来你会进入一个我管它叫执行舱的界面,一根很粗的进度条,写着已完成 3/18 行,下面有个滚动的预览区,AI每处理完一行,结果就像打字机一样蹦出来。中途想走?有暂停按钮。回来接着点继续,从断的那行重新跑。
坦率的讲,界面做到这步,只是及格。真正让我掉了一把头发的,是让这1000行稳定跑完不崩。
你可能不知道,浏览器对标签页有多狠。
你切到别的网页去干别的,Chrome会觉得你这个标签页没人看了,把它的定时器压到一秒只准跑一次,内存紧张的时候甚至会直接把整个标签页杀掉。更别提GPU了,系统心情不好就把显卡上下文收回去,你的AI当场断气。
我一开始想得很美,用户不让它进后台不就行了。后来发现不行,处理1000行可能要半小时起步,你不可能要求一个人盯着进度条半小时。
于是就有了各种比较骚的操作。
第一个,声音保活。开始处理的时候,插件会用Web Audio API循环播放一段完全静音的音频。Chrome有个逻辑,正在播放音频的页面会被判定为你正在关注的多媒体页面,各种严苛的节流和查杀都会放过它。代价是标签页上会多一个小喇叭图标,所以我得在界面上跟用户解释,这个小喇叭不是坏了,是为了防止大模型睡着。
对,我用一段没有声音的声音,骗过了Chrome。
第二个,呼吸节律。每处理完一行,强制让程序睡50毫秒,每5行再多睡200毫秒。为啥要故意变慢?因为如果不给浏览器喘气的时间,页面会假死,用户会以为它崩了。最开始的版本我设的是每行睡300毫秒,后来一算,1000行就是5分钟纯空转,尼玛,太浪费了,才改成现在这个动态节律。
第三个,断点续传。每一行处理完,立刻把进度写进浏览器的IndexedDB。哪怕处理到第800行的时候电脑断电了,重启浏览器打开插件,它会问你,检测到未完成的任务,是否继续?游标指在801,接着跑。
还有一个细节我特别想聊。大模型这东西吧,你让它判断情感,它有时候会回你一句,好的,我的分析结果是,正面。
前面那一堆全是废话。处理一行还行,处理1000行,导出的表格里全是「好的」「希望对你有帮助」,那是要疯的。所以插件底层拼死了一个系统级提示词,你是一个Excel数据提取程序,只输出最终结果,严禁输出任何解释性文字或礼貌用语。写出来之前还要再用正则洗一遍,把各种代码块符号刮干净。
你看,一个看起来简单的工具,底下埋的全是这种跟浏览器斗智斗勇的细节。我自己也是踩了无数的坑才搞明白这些,愚钝如我,光是一个标签页被Chrome偷偷杀掉的问题,就折腾了好几天。
说到这个,我最近聊东西总喜欢往大了聊一层。
我一直觉得,计算这东西是个钟摆。最早是大型机,所有人排队用一台机器。后来个人电脑把算力还给了每个人。再后来云计算又把一切收回去,你租算力,租存储,把数据交出去换方便。这个交换用了十几年,大家都习惯了,习惯到忘了另一个选项的存在。
而WebGPU这种东西出现之后,我有时候会觉得,钟摆可能正在往回摆。你的电脑里躺着一塊能跑15亿参数模型的显卡,只是过去没有一个顺手的入口去用它。现在浏览器,这个全世界装机量最大的软件,成了那个入口。
2019年有一篇很有名的技术宣言,叫Local-first software,本地优先软件,讲的就是这个方向,你的数据应该长在你自己的设备上,网络只是加速器,而不是命脉。当时看觉得是个理想主义的倡议,现在一个15亿参数的模型真的能住进一个标签页里,这事儿突然就不那么理想主义了。
当然,这玩意儿现在还很粗糙。1.5B的模型,聪明程度肯定比不上云上那些大家伙,复杂任务会出错,得靠人复核。显卡太老的电脑,第一关体检都过不去。这些我都得诚实讲,它不是万能的,它只是把「批量处理1000行文本」这种最常见也最枯燥的活儿,从云上拽回了你自己的机器。
回到开头那个周五下午的行政。
1000行客户反馈,拖进去,填一句判断正面还是负面,点开始,然后去接了杯水。回来的时候进度条走了一小半,标签页上的小喇叭安安静静地闪。数据哪儿都没去,就躺在她自己的电脑里。
我始终觉得,技术最好的样子不是让你仰望它,而是你根本感觉不到它的存在,它就默默把活干了。
磨平一些信息差,从把AI塞进每个人的浏览器开始。
/ 注意,本项目仅在 SyncMein 的500人小群分享。
/ 谢谢你看完了我的文章,我们下次再见吧。
/ 作者:明察
/ 投稿或爆料,请联系邮箱:mingcha@gqmg.com



暂无评论内容