
前言:服务悄悄挂掉没人发现,是很多小团队最怕的事。本文分享一个油猴脚本服务监控方案:装上 Tampermonkey,把浏览器右下角变成监控哨兵,定时并发检测接口状态,用绿红格子时间线直观展示可用性,并通过企业微信推送异常通知。相比 Uptime Kuma 等方案更轻量,无需部署,还解决了定时器节流与多标签页选主等细节问题。
我在浏览器右下角,养了一个监控哨兵
前两天下午,我正在网页后台查资料,屏幕右下角突然弹了一条系统通知。
点开一看,我们一个生产接口,挂了。
有意思的是,我当时压根没开任何监控后台,也没开着什么运维大屏。这条通知,是从浏览器右下角一个 📡 小球里弹出来的。那个小球就蹲在页面角落里,不声不响,已经跟了我好几个月。
它是我自己写的一个油猴脚本,叫服务监控面板。今天想跟你们聊聊这玩意儿。
事情要从更早说起。
我们这种小团队,线上跑着十几个接口,没有专职运维。之前最怕的就是服务悄悄挂掉,没人发现,最后用户在群里问一句「你们系统是不是崩了」,才手忙脚乱地去重启。最离谱的一次,一个服务挂了小半天,最先发现的居然是用户。你敢信???
那种感觉真的很差。不是心疼服务器,是觉得自己像个小偷,偷了大家的信任,还偷得悄无声息。
按理说这事有成熟方案。Uptime Kuma 很火,开源免费,界面也漂亮,但它得自己找台机器布署。云厂商的监控倒是省心,可配置项一堆,还要按量掏钱。我不是说这些不行,是说对「就盯十几个 URL」这个需求来说,它们都太重了,重到你会一直拖延,拖到下次服务挂掉。
后来有天晚上我在想一个问题,我一天到晚开着浏览器,浏览器本身就是一个常驻的、能发 HTTP 请求的运行时,为什么不让它顺便当监控?
于是就有了这个脚本。
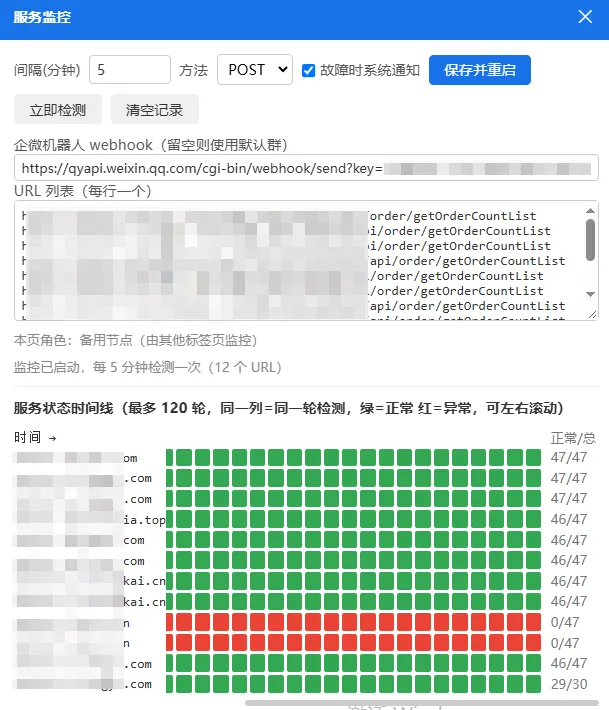
装好 Tampermonkey,导入脚本,之后你打开任何网页,右下角都会多一个 📡 悬浮球。点开是一个面板,URL 一行一个填进去,间隔设个几分钟,保存,完事。默认每 5 分钟把列表里的接口并发请求一遍,返回 2xx 或者 3xx 就算活着,其他一律算异常。
面板下面是一条时间线,这是整个脚本里我最得意的部分。
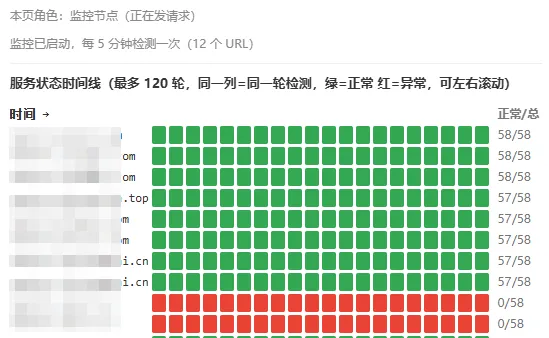
一轮检测就是一列,绿格子正常,红格子异常,从左往右横向滚动,就是这几个服务过去十个小时的人生。悬停任意一个格子,会浮出一张小卡片,主机、时间、HTTP 状态码、耗时、报错信息,全在。悬停表头,能看到那一轮检测的完整时间点。左边的主机名列和右边「正常/总」的统计列都是 sticky 的,不管时间线滚到多远,这两列钉死不动,你永远知道自己在看谁、它整体活得怎么样。
还有一个我自己特别喜欢的细节,呼吸格。
检测开始的那一瞬间,时间线最右边就会长出一列灰色的、一闪一闪的「检测中」。哪个接口先返回,哪个格子就原地变色,不用等最慢的那个磨蹭完。十几个接口并发跑,快的 200 毫秒就绿了,慢的还在闪,整个面板是活的,你能亲眼看着结果一格一格亮起来。
这种感觉,怎么说呢,有点像看心电图。
当然,写的过程里坑也没少踩。
最坑的一个还是 Tampermonkey 自己的。TM 升到 5.3 之后,Chromium 的 MV3 环境有个已知问题,GM_xmlhttpRequest 会被串行化。本来十几个接口是并发的,一升级,变成一个接一个排队,一轮检测被拖得老长。我去翻它的 GitHub,翻到 issue #2215,底下哀鸿遍野,全是被坑的人。官方给了一个 workaround,发请求的时候把 redirect 设成 manual,遇到 3xx 手动跟一遍,并行就回来了。代价是不支持 onprogress 和 401 认证,好在我这都用不上。
把 workaround 内联进脚本、看着十几个请求重新齐刷刷一起飞出去的那一刻,太爽了。
调度这块也翻过车。一开始图省事用的 setInterval,后来发现标签页在后台待久了,定时会被浏览器节流,一轮和一轮之间的间隔越漂越离谱。改成 setTimeout 链式,每轮从上一轮结束的时间点起算,才算稳住。另外标签页从后台切回前台的时候,如果发现已经错过了检测时间,立即补跑一轮,不傻等。这些都是不起眼的小细节,单拎出来哪个都不值一提,堆在一起才是「用着不膈应」。
再说一个你可能已经想到的问题。
浏览器嘛,你肯定不是只开一个标签页。要是每个标签页都发请求、都推送,企微群分分钟被轰炸成瀑布。所以脚本里做了个多标签选主,各个标签页用心跳竞争一个主节点身份,20 秒一跳,90 秒没动静就判定掉线,备用的自动顶上。启动的时候还随机延迟个零到一点五秒,降低大家同时抢的概率。
主节点切换的时候有个很隐蔽的坑,接管那一刻,新主节点不知道之前已经推送过哪些故障,容易把老故障当新故障再推一遍。所以接管时会从历史记录里回溯,把连续故障的起始时间找出来,重建异常状态。这样推送里「已持续 47 分钟」这种数字才是准的,而不是每次接管都从零开始计。
通知策略这块,我刻意做得非常克制,只在三种时刻说话。状态从正常翻成异常的那一刻,说一次。一直没好,那每个自然日提醒一条,不刷屏。恢复了,再说一次,附上这次一共挂了多久。
持续挂一整晚,你收到的不会是 96 条消息,是两三条。
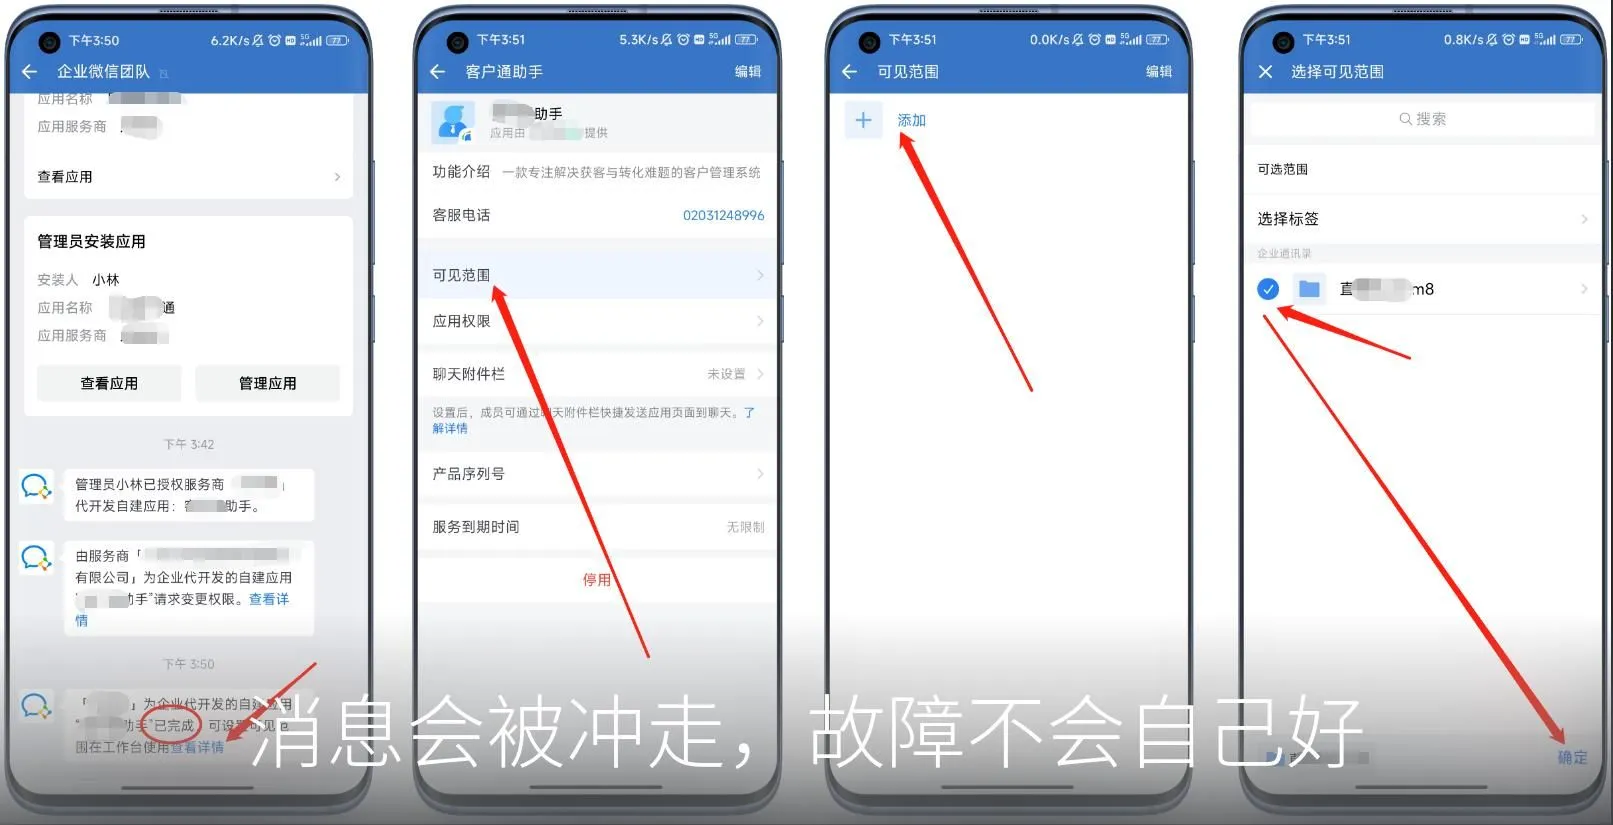
而且每条通知里还会附一个「仍未恢复」的列表,把今天已经提醒过、但现在还红着的 URL 再列一遍。这个设计是因为我自己就干过这种事,看到第一条推送,处理了一下,然后就被别的事打断,把这茬忘了,服务其实还红着。消息会被冲走,但故障不会自己好。
写到这,我想聊点别的。
医学上有个病,叫先天性无痛觉症,英文缩写 CIPA。得了这个病的人,感觉不到疼。听起来像超能力对吧,其实是灾难。这样的孩子出牙期会把自己的手指咬得血肉模糊,骨折了照常跑跳,阑尾炎穿孔了才发现不对劲。因为疼这个东西,从来不是身体在折磨你,是身体在给你报信。
疼是信号。感觉不到疼的人,伤会无声地累积。
服务也一样。接口挂掉本身不可怕,可怕的是它挂了没人知道,它在无声地流血,而所有人都以为一切正常。所谓监控,就是给系统装上神经系统。那个 📡 小球,那条企微推送,就是痛觉。绿格子是岁月静好,红格子是一声「疼」。
我有时候觉得,做技术这些年,最大的进步不是又学了几个框架,而是终于承认了一个特别朴素的事实,你感觉不到疼,不代表你没有伤。
回到开头那条通知。
那天下午我点开面板,时间线最右边一格红得刺眼,往前滚,是一整条整齐的绿。定位,重启,恢复通知弹出来,上面写着已持续 23 分钟。
要是没有这个小球,这 23 分钟,大概率会变成 23 个小时,等到某个用户忍无可忍地来问我们。
如果你手上也有一堆接口要看着,又不想为这事专门部署一套监控系统,可以试试把浏览器变成哨兵。一个油猴脚本,十几行配置,成本约等于零。
它不会让你的服务更稳定,但能让你在服务流血的第一时间,就感觉到疼。
这就够了。
/ 注意,本项目仅在 SyncMein 的500人小群分享。
/ 谢谢你看完了我的文章,我们下次再见吧。
/ 作者:明察
/ 投稿或爆料,请联系邮箱:mingcha@gqmg.com



暂无评论内容