
前言:百万级数据的AI打标验证难点不在跑模型,而在成本、速度与准确率的平衡。本文给出黄金标准集、置信度分层抽样、历史数据校准阈值、复核UI设计与大小模型级联方案,让大模型reasoning反哺Jev,人工只需看几千条即可守住百万数据的准确率,别再全量人工看三年。
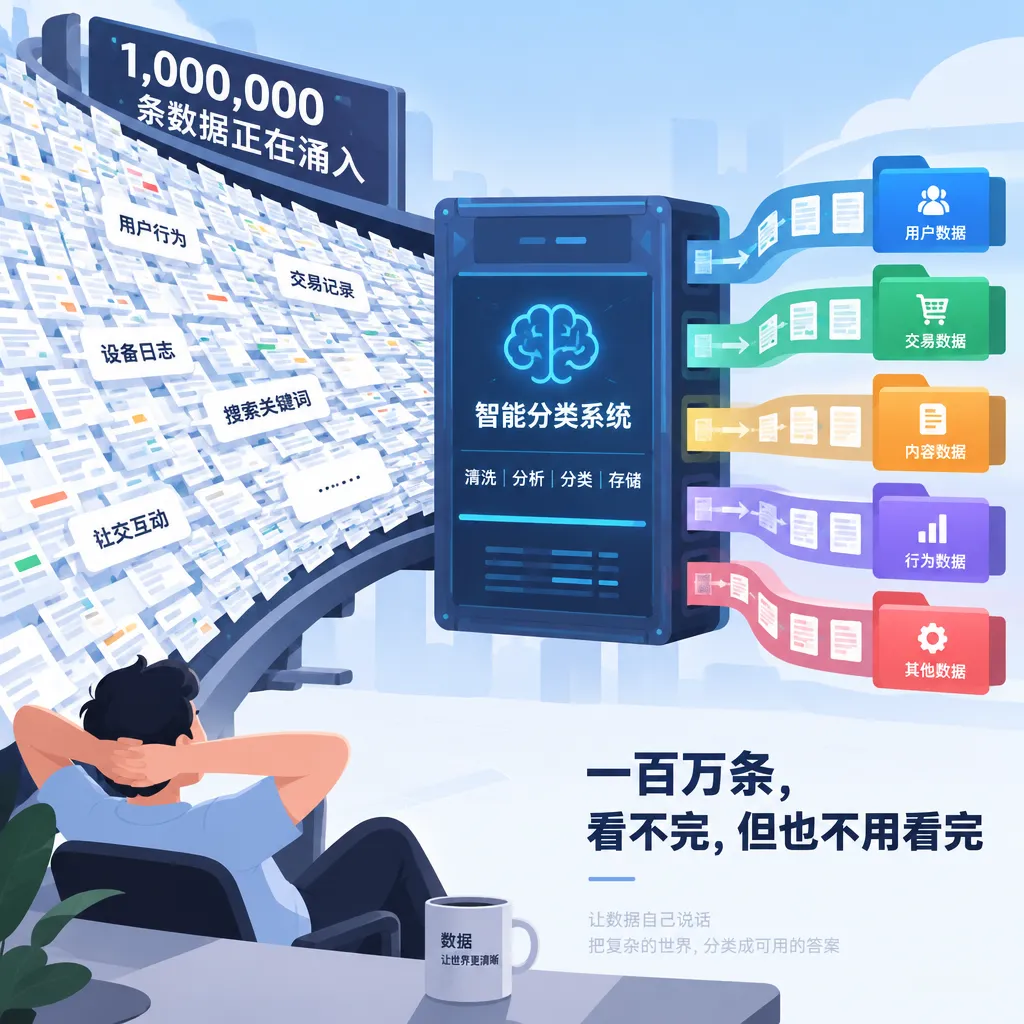
一百万条数据要打标,你怎么知道AI标对了?
前两天跟一个做数据的朋友吃饭,他跟我倒苦水,我觉得这事儿挺值得展开讲讲的。
他们库里攒了一百多万条用户文本,准备用 TypeSafe AI 的 Jev 跑一遍分类打标,打完直接进下游的业务路由。跑模型本身不是问题,一晚上估计就跑完了,他卡住的地方在后面,跑完之后,我怎么知道它标得对不对?
总不能人工看一百万条吧。
我帮他算了笔账,按一个人一天看800条,一百万条要看三年多。而且看到第二年的时候,人的状态已经不对了,疲劳状态下的人工准确率,搞不好还没模型高,你看出来的结果自己都没法信。
这个问题其实特别典型。百万级数据的分类打标,难点从来不是跑模型,跑模型是最简单的部分,难点是成本、速度、准确率这三个东西怎么平衡。你想要快,就没办法全量人工验证,你想要准,钱和人力就烧不起。
我先说结论,再展开讲。结论就是,验证一百万条数据,你真正需要人工看的,可能就几千条。
前提是,你得会分层。
1、先花一天,搞一个黄金标准集
在跑全量之前,先人工精标1000条出来。这1000条要刻意覆盖每一个类别,尤其是那些平时出现不了几次的长尾类别,别偷懒全拿头部数据凑数。
然后拿这1000条喂给 Jev 跑一轮,你直接就拿到了一个 baseline 的准确率、精确率和召回率。后面所有的阈值设定、放行策略,都拿这个数字当锚点。
这1000条还有个隐藏作用,讲到第3条的时候你就明白了。
2、置信度不是装饰品,是你免费的分层依据
Jev 每次调用都会输出一个带校准概率的置信度分数。我观察到很多人拿到这个分数看都不看,只取分类结果,太浪费了,这个分数就是模型在跟你说话,它在告诉你哪几条它拿得准,哪几条它心里也虚。
完全随机抽样验证有个致命问题,长尾问题会被掩盖。你随机抽1万条,准确率看着挺美,96%,但那4%的错误可能全堆在某个你从没注意过的类别里,等业务方找上门的时候已经晚了。
所以要用置信度把数据切成三档,区别对待。
90%以上的,自动化放行,直接入库走下游。只随机抽1%到2%做个 sanity check,防的不是模型不行,防的是「自信的幻觉」,就是模型因为提示词偏差,对某一类错误产生了系统性的自信。
60%到90%的,这是重灾区。边界模糊的 hard examples 基本都堆在这个区间,抽30%到50%,或者直接导入人工复核界面。对这部分数据的纠偏,能最快暴露你业务分类规则里的漏洞,比模型本身的问题值钱多了。
60%以下的,别计入自动化成果,直接拦下来。要么进人工池全量标注,要么丢给大模型做慢速深推理,后面第5条细说。
3、用历史数据校准阈值,让数字替你说话
取1万条高质量历史数据喂给 Jev,记录它输出的置信度和预测结果,然后统计每个区间的真实准确率。比如你跑完发现,置信度88%以上的数据,实际准确率是99.2%。
这时候你跟业务方开会,姿态就完全不一样了。你不是拍脑袋说「我觉得90%可以放行」,你是拿数据说话,历史数据证明88%以上的准确率到了99.2%,甚至高于人工疲劳时的水平,所以88%就是我们的放行线。
对,前面那1000条黄金标准集,就是给这一步垫底用的。
顺便说一个特别容易被忽略的宝藏场景。如果一条历史数据,你的规则引擎判定为A,但 Jev 给了95%的高置信度判成B,别急着当错误处理,这种「高自信冲突」往往是最有价值的数据。它要么说明你的历史规则过时了,要么说明 Jev 学错了特征,不管哪种,都值得优先推到复核台上看一眼。
4、给复核的人做一个顺手的UI
中低置信度的数据终究要人看,那这个界面顺不顺手,直接决定你的验证成本。我看到不少团队把这个界面做成了一个完整的标注平台,功能贼全,然后质检员用得想骂人。
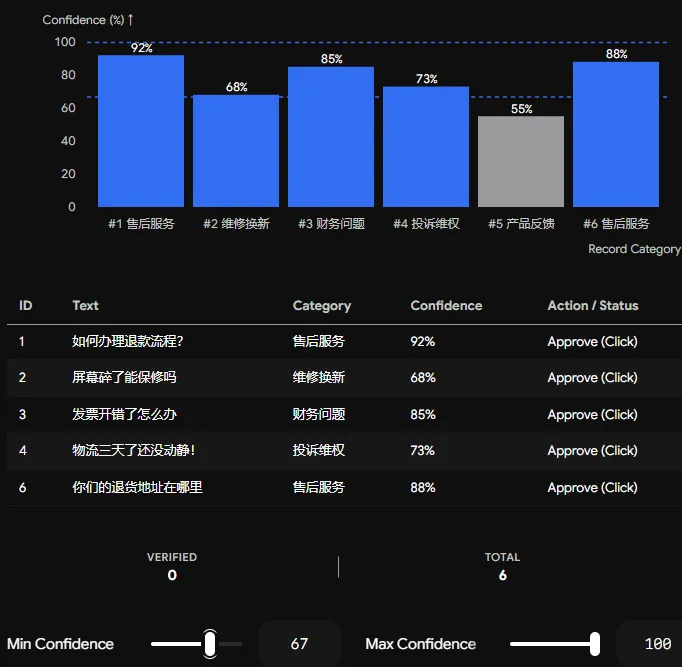
其实三个模块就够了。
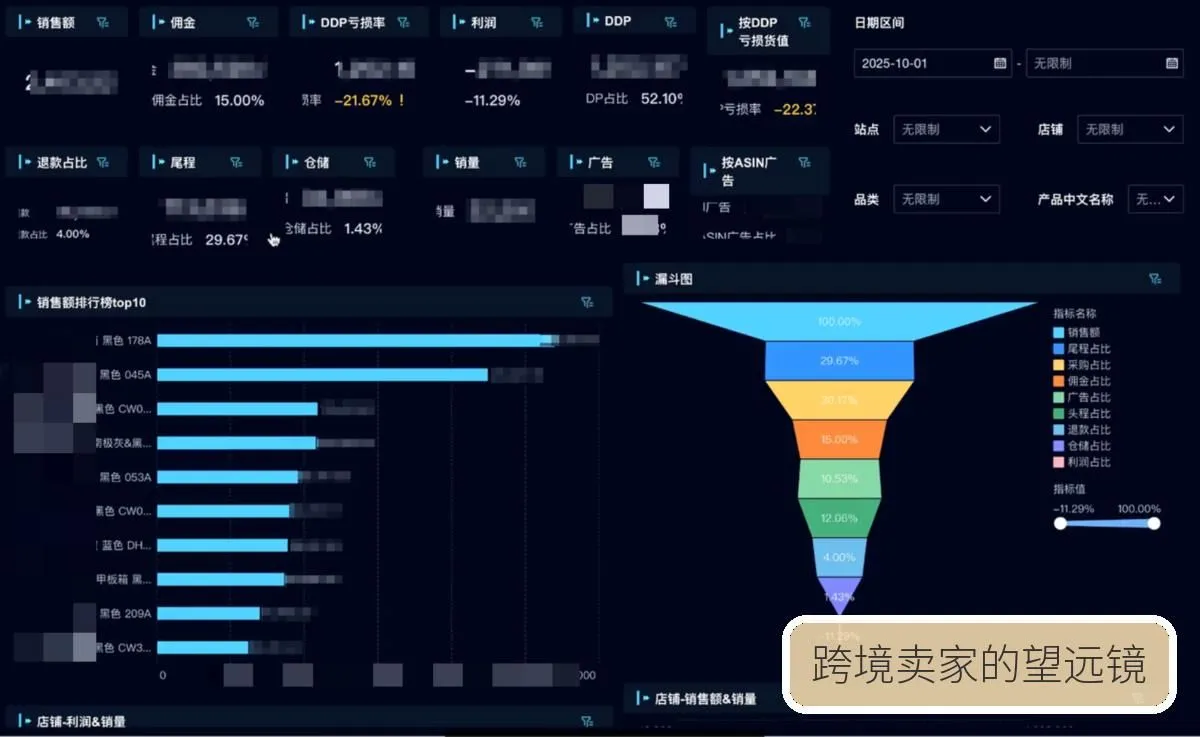
最上面一个全局直方图,实时展示百万数据跑完后的置信度分布。如果大量数据堆在低分段,先别骂模型,大概率是你的 Choice 选项定义跟实际数据分布不匹配,回去重新梳理业务规则,比调模型管用。
中间一个筛选区,阈值滑块加类别过滤,质检员可以框定审核区间,比如这周专攻70%到80%的临界数据。
主体是复核列表,左边原始文本,右边高亮 Jev 的预测结果和置信度,一个 Approve 快速通过,一个 Reject 选正确分类。
就这么多,别做复杂了。复核这种事,每多一次点击,人力成本就多一分。
5、人工还嫌贵?让大模型当裁判
如果中低置信度的占比到了10%甚至20%,全靠人工确实会拖垮进度。这时候该上大小模型级联了。
Jev 是 System 1,快,便宜,靠直觉。GPT-4o、Claude 这些是 System 2,慢,贵,但会推理。用小模型做全量廉价初筛,用大模型做局部复杂推理,这个架构现在已经是标准打法了。
但路由规则要狠,别心软。40%以下的直接标「无法识别」进人工池,别浪费大模型的 token,那种数据大模型看了也摇头。40%到80%的,才是大模型发挥价值的黄金区间。
给大模型的 prompt 别让它自由发挥,强制它先输出 reasoning 再给 final_category,最后再给一个1到10分的确定程度。强迫它先思考再下结论,准确率完全不是一个量级。
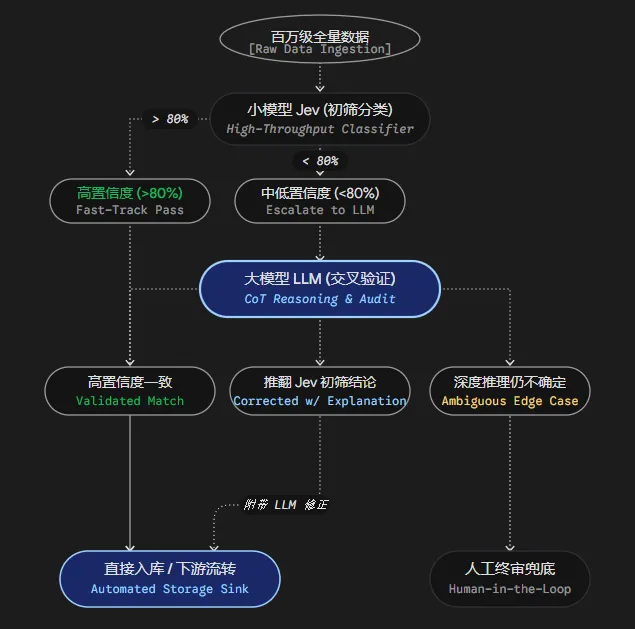
然后脚本自动决断,就三种情况。
双盲一致,大模型跟 Jev 结论一样,且分数大于等于8,直接信任,入库。大模型推翻,结论不一样但逻辑链清晰、分数够高,采用大模型的。双重迷失,大模型自己也说拿不准,这种数据可能只占总量的0.5%,才是真正需要人看的。
6、最后一步,也是最值钱的一步,让大模型的 reasoning 反哺 Jev
人工在界面上的反馈不是一次性的,大模型生成的 reasoning 也不只是用来纠偏当前这条数据,它们都是优化 Jev 的最佳素材。
定期导出一批「大模型推翻 Jev」的记录,把判定逻辑精简后,直接补进 Jev 的 Instructions 或者 Choice 的描述字段里。比如系统老把售后咨询误判成投诉维权,那就加一条边界定义,用户只问退货流程、没表达负面情绪的,一律算售后咨询。Jev 是动态配置上下文的,下一次 API 请求就生效,不用重新训练模型。
另外,你手里如果已经有历史标注数据和业务规则,别让它们躺着吃灰。正则和强特征词表做成前置旁路,命中的直接打标入库,成本为零。高质量的历史标注扔进向量库,低置信度数据来的时候,检索最相似的3到5条作为 few-shot 拼给大模型。大模型这时候不光有规则,还有「判例」,准确率还能再抬一截。
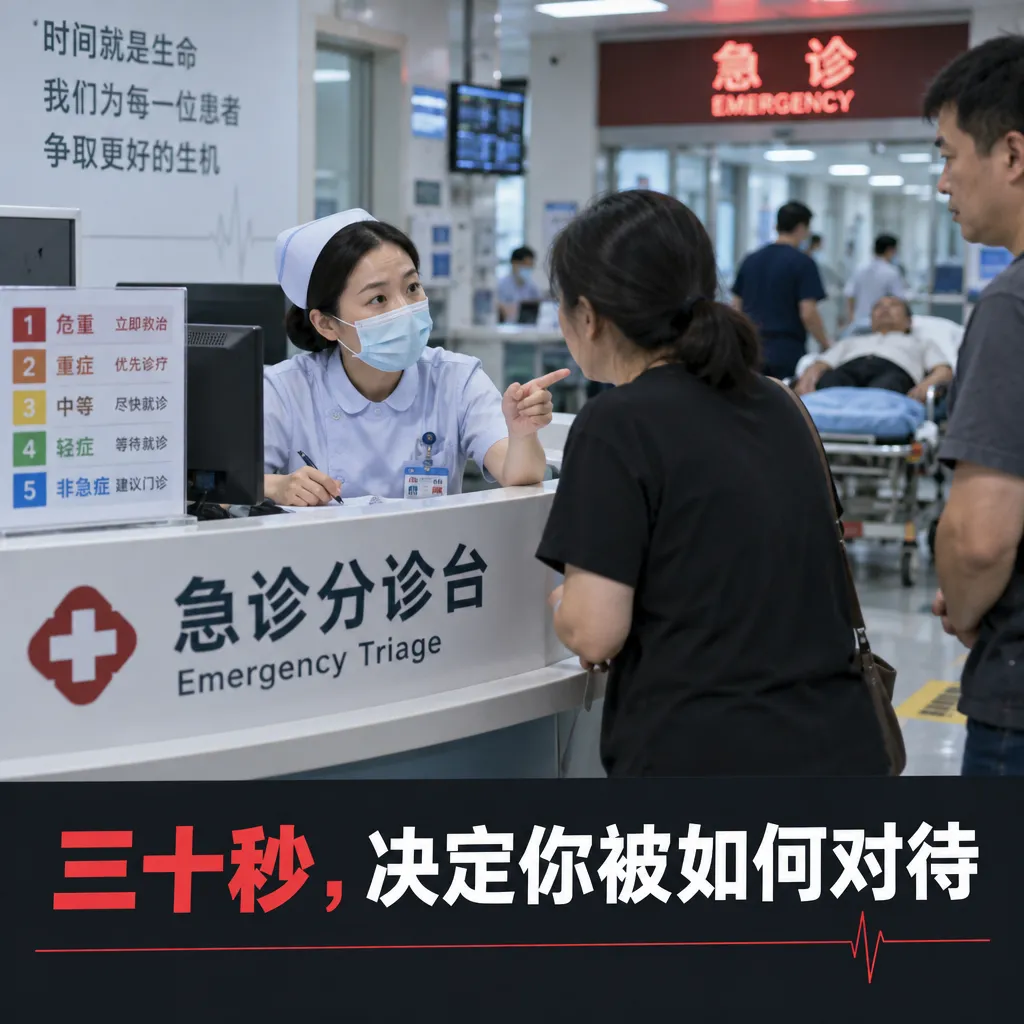
写完这一整套,我突然想到急诊室。
分诊护士不会给每个病人做全套检查,她用三十秒判断你挂哪个科、危不危险。危重的直接推进抢救室,普通的排队等着,没大事的回家。整个医院能高效运转的前提,是承认一件事,不是每个病人都值得同样的注意力。
数据验证也一样。一百万条数据里,绝大多数是模型闭着眼睛都不会错的,真正需要人类智慧的可能就那百分之几。
别把人力平摊到一百万条上,把人力砸到那几千条刀刃上。
以上是我自己也在摸索的一些不成熟的经验,具体阈值卡在88还是90,得拿你们自己的数据跑一轮才知道,我不敢替你拍这个数字。
但方向,我觉得是对的。
毕竟,磨平一些信息差,一直都是我在做的事。
/ 注意,本项目仅在 SyncMein 的500人小群分享。
/ 谢谢你看完了我的文章,我们下次再见吧。
/ 作者:明察
/ 投稿或爆料,请联系邮箱:mingcha@gqmg.com



暂无评论内容