
前言:421M的Laya小模型在客户线索筛选中,把收黄豆经纪人判定为100%大宗贸易,暴露出小模型结构化输出的致命陷阱:不幻觉不等于正确,置信度校准形同虚设。本文复盘三大检查点实测、扰动测试与黄金集评测方法,并给出规则词典加小模型粗筛加大模型兜底的三层漏斗落地方案。
一个收黄豆的经纪人,被AI判定为100%在做大宗贸易
先说一个让我当场愣住的结果。
一条用户记录,昵称叫「经纪人」,简介写着,长年收黄豆。玉米,有需要卖的,买的联糸我,后面还挂了个手机号。
一个做农产品收购的经纪人,跟金融贸易八竿子打不着。
然后我们那个号称能判断「是不是金融贸易业务」的小模型,给这条数据打了个分。
1.000。
百分之百,小数点后三位,斩钉截铁。
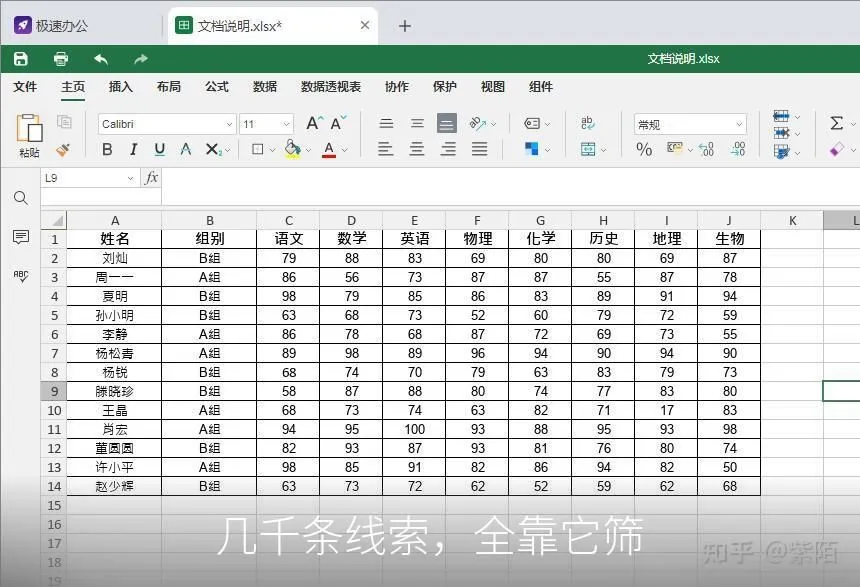
这事儿得从前几天说起。我们手里有个活儿,一张Excel,几千条采集来的用户记录,每条就俩字段,昵称加简介,要从里面筛出做资金过桥、摆账配资、大宗贸易增量业务的目标客户。这种活儿以前全靠人肉刷,几千条看下来,眼睛都直了。
所以看到 Laya 的时候,我是真的心动了。421M的小模型,官方说单问题33毫秒,批量7毫秒一题,T4上实测。最骚的是它的思路,不生成文本,直接输出结构化的概率和置信度,没有幻觉,不需要解析输出,分数过阈值就能自动决策。而且它还有专门的多语种检查点,中文看着是有备而来的。
我寻思这不就是为这种场景量身定做的吗。装上,照着文档写了个 laya.load() 加 agent.predict(),美滋滋。
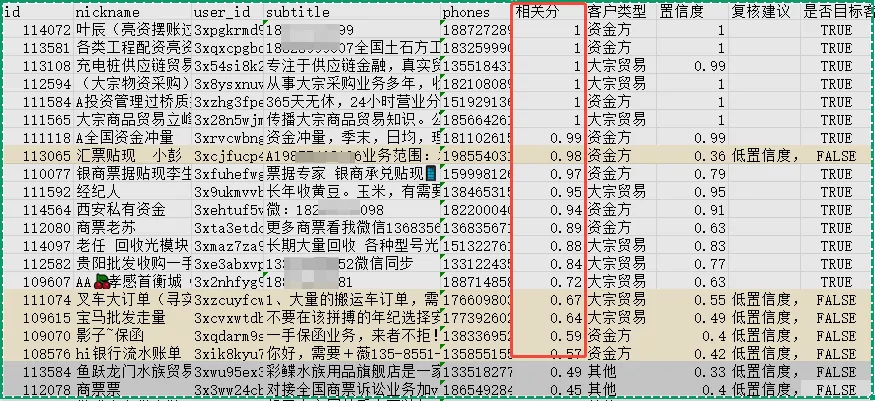
结果一跑,42条数据里,相关度大面积的1.0。
得分全挤在高位,区分度约等于没有。最刺眼的就是开头那条收黄豆的经纪人,还有个做留学自媒体的「留学口水菌」,简介是帮你避开留学中的那些坑。俩人,双双1.000,被这个判断器拍着胸脯判定为金融贸易业务。
我当时就盯着屏幕,???
第一反应当然是怀疑自己。阈值没调好?权重下错了?还是用法不对?
先换权重。官方一共三个检查点,我全下下来了,laya 0.3.4,一条条跑。测试用例5条,2条明确是目标,3条明确无关。
先跑官方推荐的中文检查点 multilingual。留学口水菌被它的choice分类头判成了大宗贸易,置信度0.85,还特么特别有信心。收黄豆的经纪人被分到实体厂家,0.92。五条里四条的noul饱和在1.0,包括两条明确无关的。
行,换下一个。typed-decisions,这个更绝。表面上不饱和了,但你仔细看,所有选项的概率全被压平在0.15到0.46的窄带里,置信度全线0.02到0.08,目标记录和无关记录的概率分布几乎完全重叠,分数排序基本等于抛硬币。
它不是不饱和了,它是躺平了。
再换英文根检查点 english-root,noul又饱和回去了,0.76到0.96,连一条明显无关的机械厂记录都给了0.76。
三个检查点,同一个病。换权重,救不了。
接着排除用法问题。是不是state格式不对?JSON字典和纯文本各传一遍,两条无关记录,双双1.000,格式无影响。是不是中文instructions失效?换成英文,无关记录还是1.000,更骚的是那条真正做亮资摆账的目标记录,分数从0.931直接掉到0.076,方向都给你干反了。
最后试了在criteria里加负例提示,明告诉它留学中介、农产品收购不算大宗贸易。这条还真有效,留学博主从大宗贸易0.95掉到了other 0.46。但代价是那条亮资摆账的目标记录,从资金方0.49掉到了other 0.35。
按下葫芦浮起瓢。修好一个案例,另一个就退化。在小模型上,这种修正就是零和的打地鼠。
到这一步我基本判了死刑。noul这个头对中文几乎恒为高分,choice要么误判要么没区分度,置信度这个字段完全不具备可解释性。这不是调参的问题,是421M的中文能力天花板就搁在那。
但活儿还得干啊。
后来跑通的方案,说穿了就是绕道。既然noul不可用,那就彻底放弃它,改用choice题型里目标类型的概率求和当相关分,资金方的概率加大宗贸易的概率,超过0.5,并且置信度不低于0.6,才放行。低置信度的一律挂起,进人工复核。
实测,分数终于拉开了。充电桩供应链贸易增量,相关分0.98,置信度0.90,正确命中。收黄豆的经纪人,0.04,排除。机械厂,0.01,排除。
但你要是以为模型变聪明了,那就太天真了。真正命中的那几条目标,比如亮资摆账那条,相关分0.54,置信度0.02,是被「置信度太低转人工」这条规则兜住的,不是模型判对的。留学口水菌还被误判成大宗贸易,相关分0.51,同样靠低置信度兜住。
这个方案真正的价值,不是它变聪明了,是它终于知道自己不知道。

说到这个,我特别想聊聊整个事儿里最让我后背发凉的部分。
不是模型不行。是它的错误,长得特别像正确。
你想想看,如果模型输出的是一段自然语言,说这位收黄豆的经纪人是一位资深大宗贸易从业者,你一眼就能看出荒谬,直接把结果扔了。但Laya输出的是什么呢,是一份干干净净的结构化数据,noul等于1.0,confidence等于0.85。无幻觉,结构化,看起来无比可信,然后它就顺着你的自动化管线,流进你的业务决策里去了。
不幻觉,不等于正确。结构化输出最大的陷阱,就是让错误答案看起来像正确答案。
官方宣传里那些漂亮的词,校准的布尔概率,中文输入下恒为1.0,校准性为零。多语种支持100多门语言,支持,不等于可用。7毫秒一题,速度是真的,快得毫无意义,快速地给出错误答案,那不叫效率,那叫高效地生产垃圾。
这话听着有点刺耳,但我得先给自己也来一刀。这次评测就5、6条测试用例加42条真实数据,小样本,单任务,非正式,结论只对我们这个场景负责。Laya在英文工单分派、内容审核那些事上可能完全正常,421M做到这个推理速度,工程上很有价值。这盆冷水不是泼给Laya的,是泼给「看到benchmark就敢上生产」的我们自己。
聊到这儿的时候,我突然想起经济学里那句老话,宁要模糊的正确,不要精确的错误。以前觉得这就是句正确的废话,这次算是被1.000这个数字结结实实上了一课。卡尼曼说人有系统一和系统二,系统一快,直觉,爱下结论,系统二慢,但讲证据。小模型就是系统一,33毫秒给你答案,爽是爽,但你不能让系统一签字画押,去驱动一个自动执行的闭环。
所以如果你也要在自己的业务里用这类小模型,说几句我不成熟的经验。别信模型卡,自己搭评测,拿20到50条真实数据做黄金集,正例反例边界案例都放一点,人工标好。然后看区分度,别看绝对值,正例的分数分布和反例的分数分布分不分离,重叠区有多大,我们就是在这一步发现noul完全重叠的。再看置信度,高置信度的样本是不是真的更准,如果高置信度也大量出错,这个字段就是装饰品。最后做个扰动测试,换个格式换个措辞加个错别字,结论还稳不稳。要是大量输出挤在0.0或者1.0,别调了,模型在这个分布上压根没学会,阈值调到天荒地老也是徒劳。
场景上,英文分类、大批量粗筛的第一道漏斗、有下游人工兜底的环节,可以用。中文语义判断直接驱动自动决策、分数过线就自动执行、拿置信度当可靠性,别碰。
架构上,别指望一个模型包打天下。我们后来想明白的打法是三层漏斗。最上面一层是规则词典,亮资、摆账、贴息、过桥这些强金融黑话,正则直接命中,零耗时零成本。中间才是Laya这种小模型,用它的快,把明显无关的先淘汰掉。最底下兜底的是成熟的中文大模型,GLM、Qwen、DeepSeek,配合JSON Schema接住所有低置信度的疑难杂症。小模型管不了长尾,就让大模型来。
对了,还有个小细节,数据进模型之前,先用正则把手机号微信号这些噪音剔干净,别让421M那点可怜的注意力被一串138开头的数字带偏。小模型就那么大点脑容量,你多喂它一克噪音,它就少一克算力去理解语义。
回到开头那个收黄豆的经纪人。
他可能在东北某个粮库边上,一年到头盯着黄豆和玉米的行情,手机里存着几百个农户的电话。他大概一辈子都不会知道,自己有一天被一个421M参数的模型,用小数点后三位的把握,判定成了一位大宗贸易领域的资深从业者。
1.000。
他要是知道了,估计也就回一句,俺们这儿不玩这个。
模型卡上的指标,和你的业务能不能用之间,隔着一整套你必须在自己数据上做的验证。能磨平这层信息差的,从来不是榜单,是你自己下场跑的那一遍。
/ 注意,本项目仅在 SyncMein 的500人小群分享。
/ 谢谢你看完了我的文章,我们下次再见吧。
/ 作者:明察
/ 投稿或爆料,请联系邮箱:mingcha@gqmg.com



暂无评论内容