
前言:视频关键帧抽取是让AI看懂视频的第一步。本文拆解开源工具:不调用任何大模型,仅靠numpy与ffmpeg做像素差异检测和动态阈值选帧,配合状态机避开转场模糊帧,再用抽稀控制帧数;针对多模态模型视频抽帧,还专门优化了视频总览图像素预算与分张逻辑,避免画面糊成一片。看完你就知道,喂给AI的内容,呈现方式得按模型的眼睛来设计。
一个没调用任何AI的脚本,却在疯狂讨好AI的眼睛
我前两天刚好在折腾一件事,让AI看懂一段视频。
听起来很简单对吧,把视频丢给多模态模型,让它告诉我里面到底讲了啥。
结果一上手,全是坑。
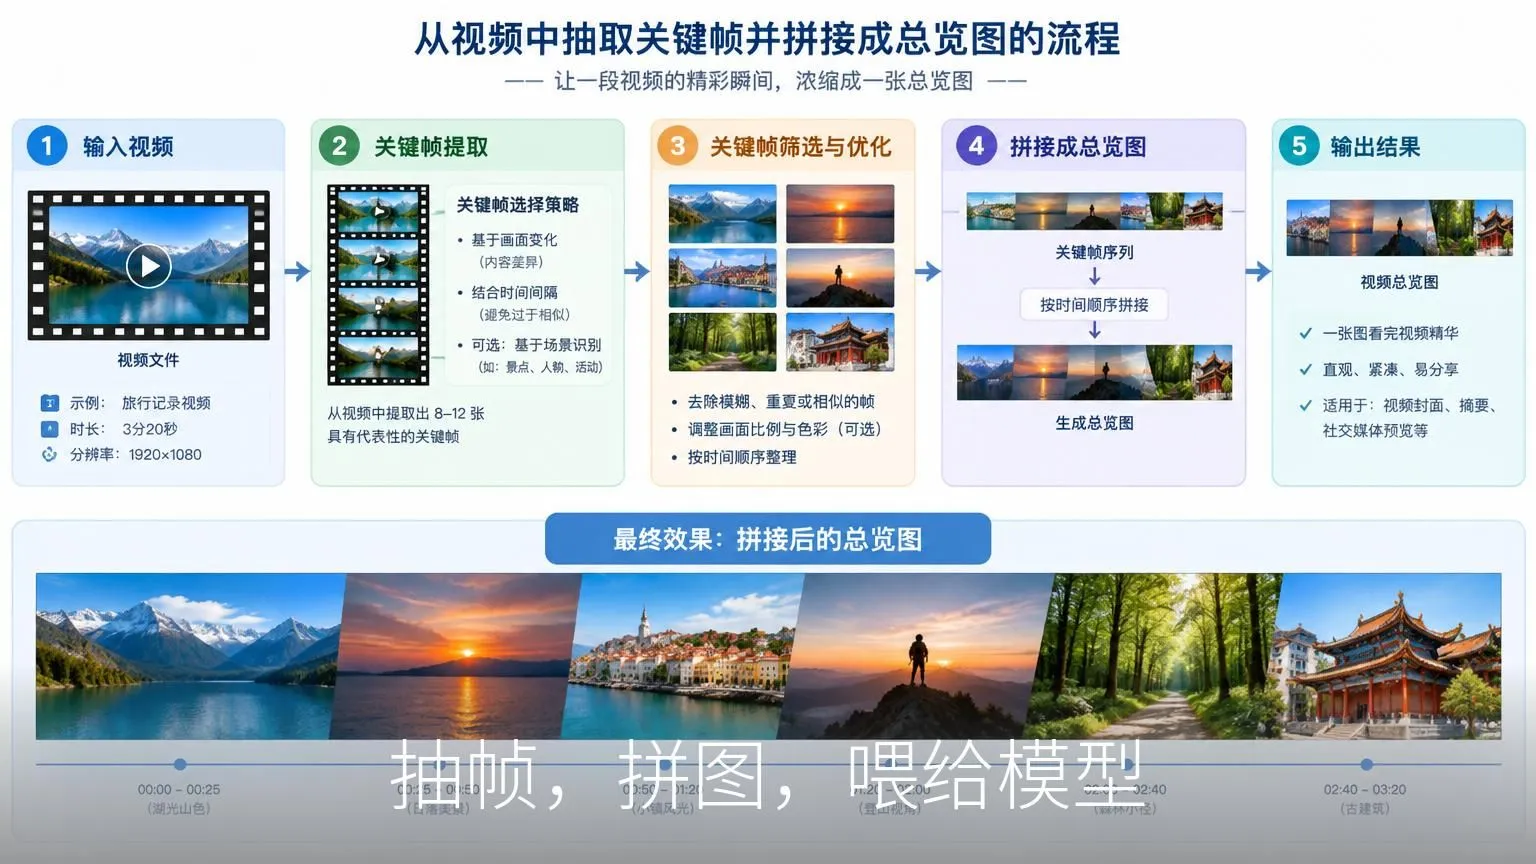
第一个坑,帧太多。一段3分钟的视频有5000多帧,全喂进去,又贵又没用,绝大部分帧长得一模一样。第二个坑,图太糊。把几百帧拼成一张巨图,图是够大了,但读图工具会把整张图压缩到长边一千五百多像素再交给模型,每格只剩一两百像素,字幕糊成一团。
模型看啥呢,什么都看不清。
我就在想,这个环节,怎么就没人好好做一下。
然后我就看到了一个抽关键帧的脚本。本来我以为又是一个平平无奇的工具,毕竟抽帧这活儿,ffmpeg一条命令就能干。
结果我把它的源码和文档翻了个底朝天之后,整个人有点不太好了。
怎么说呢,这个脚本从头到尾,没有调用任何一次AI。没有大模型,没有任何识别,纯纯的numpy加ffmpeg,靠像素矩阵相减算差异。
但它整个设计,每一个参数,每一行注释,都在疯狂讨好AI的眼睛。
你敢信???
一个完全没有AI的程序,它的目标用户,居然是一个AI。
这个反差给我一下子整不会了,我寻思了一下,没寻思明白,索性从头到尾把它捋了一遍,看它到底是怎么做到的。
先说它干活的思路,两遍扫描。第一遍,用最低的成本搞清楚哪些帧变了,第二遍,把真正选中的帧高清地导出来。听着很合理对吧,但细节才是真有意思的地方。
第一遍扫描,它不会傻乎乎地去解码全尺寸高清彩色视频,那太慢了。它用ffmpeg把视频直接压成一个宽度200像素左右的灰度裸流,然后在Python里逐帧读,比较当前帧和上一帧的差异。
200像素,灰度,你想想看,这个分辨率,人眼基本看不出啥,但对判断画面有没有变来说,绰绰有余,速度快到飞起。
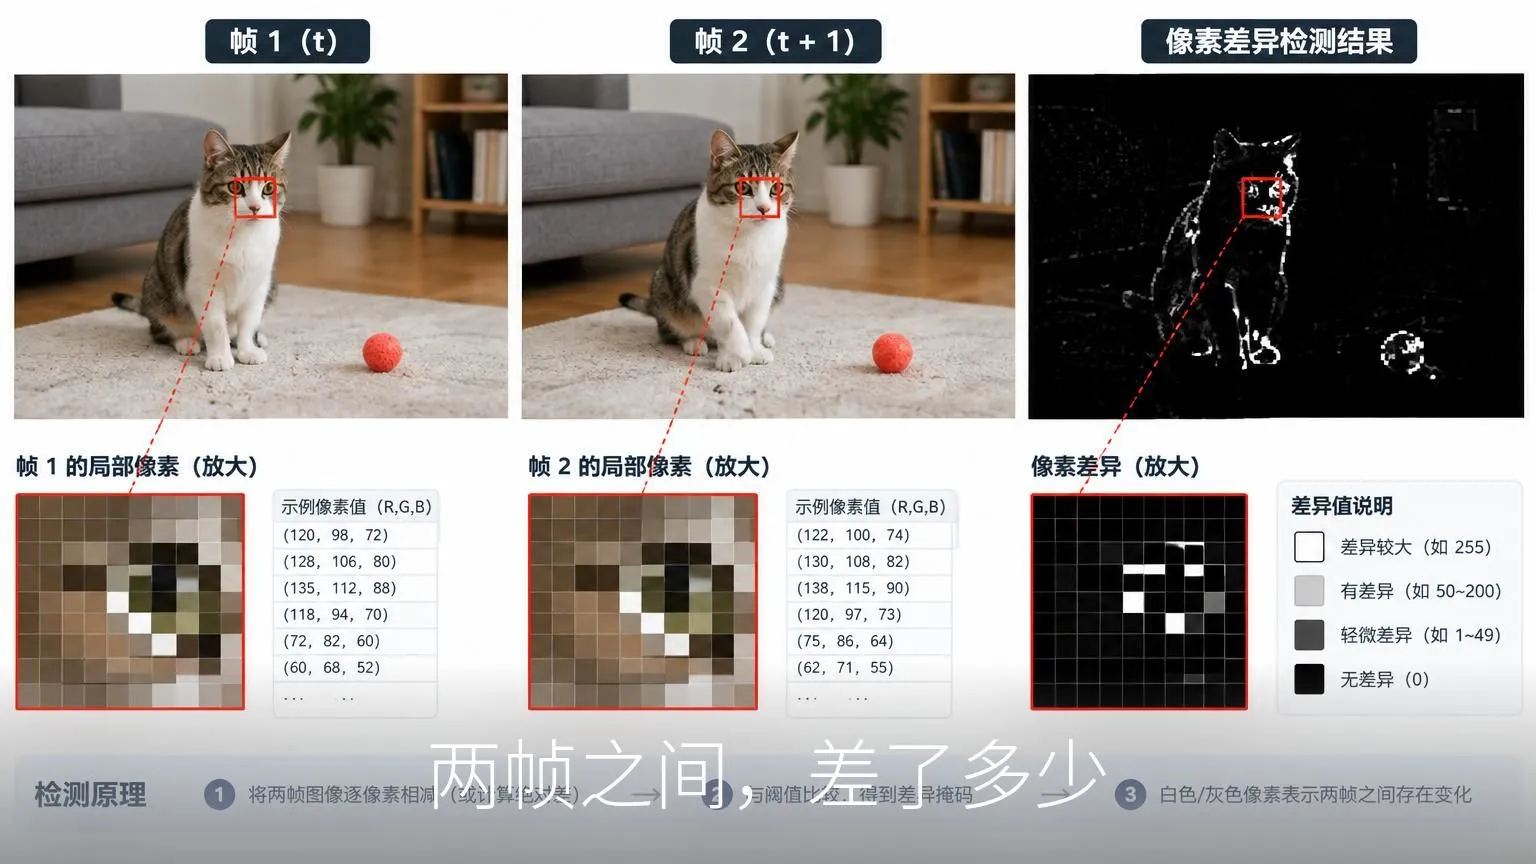
但这里有个细节,是代码里最精彩的一笔。算差异的时候,它不光看全局平均差异,还把画面切成8×8的网格,提取局部差异最大的那一块。为啥呢,因为只盯全局平均的话,角落弹出来一个小字幕,或者一个小物体移动了,这点变化会被大量没变的像素稀释掉,实测差异只有0.004,跟噪声一个量级,直接被忽略。看分块的话,能拿到0.06,区分度干净得多。
我当时看到这行代码,就愣住了。这个细节太特么细了,它连字幕从角落弹出来这种场景都想到了。
然后就是选帧的决策逻辑,这块更有意思。视频大部分时间画面是静止的,但因为压缩噪点,相邻帧之间总有点微小的抖动。脚本怎么区分噪点和真变化呢,它把所有帧的差异分数取中位数,当成底噪,再乘一个倍数,默认4.0,得出一个动态阈值,然后夹在0.008到0.08之间,防止跑偏。
完全不需要手动调参。
而且这里有个反直觉的坑,是它在文档里专门写出来的。你可能觉得,画面变化不够的时候,调高阈值就能少抽点帧对吧。
大错特错。
元素淡入淡出这种渐进动画,调高阈值之后就不再被当成变化了,算法会在动画中途误判成变化已经结束,抽出来一堆元素还没出现或者已经消失的空白画面。它文档里给的实测数据是,同一段视频,自动阈值抽出134帧,每帧都有完整内容,阈值调到0.03之后只剩19帧,一多半是空白。
所以它的建议是,想少抽帧,别调阈值,用抽稀。抽稀是在已经选好的好帧里均匀挑,画面质量不受影响。
这个思路,怎么说呢,很工程师,也很实在。
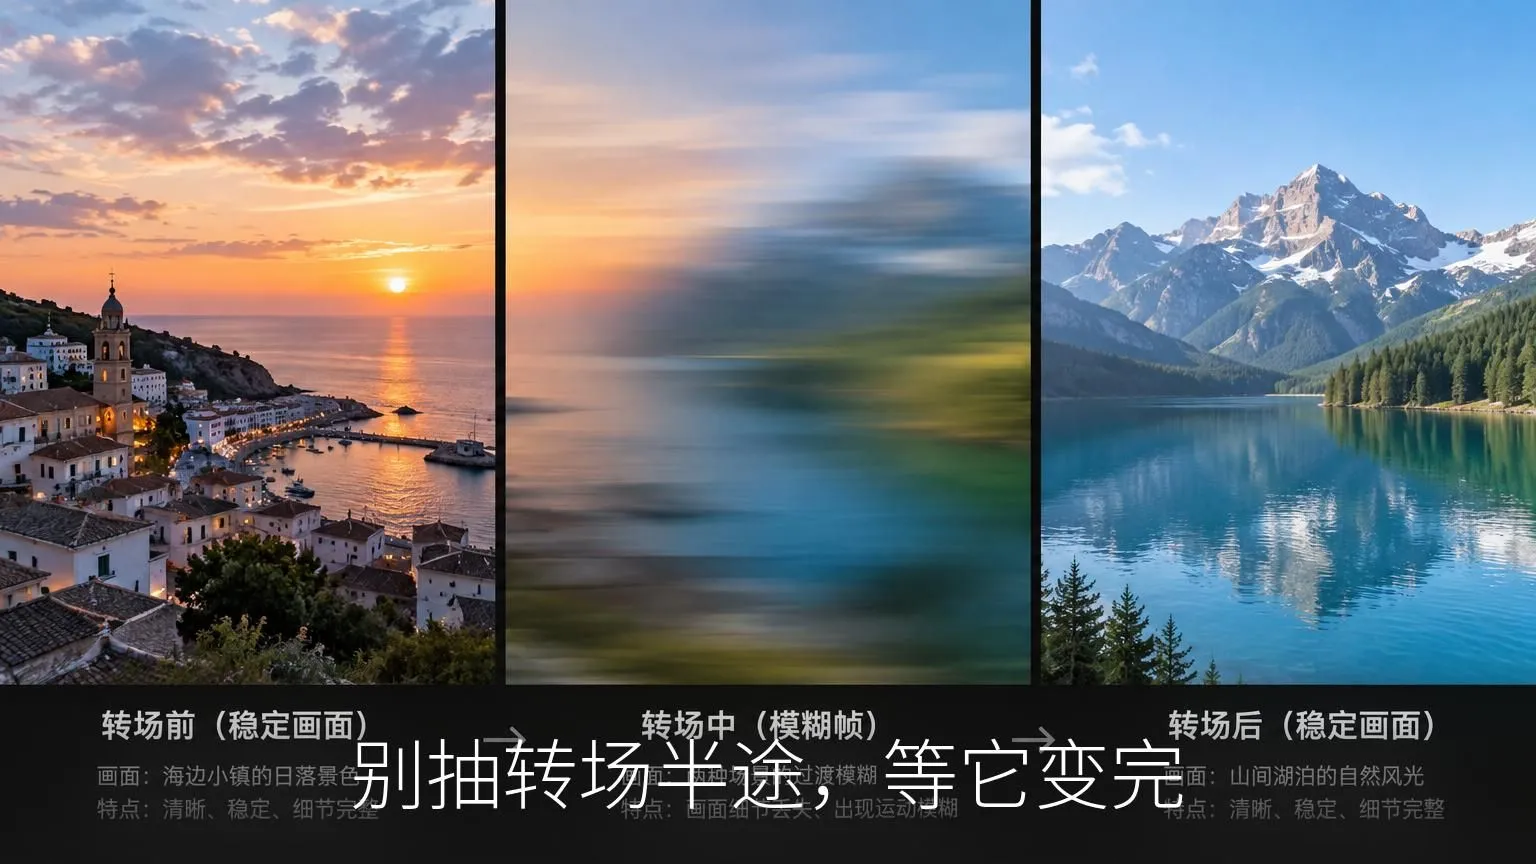
选帧还有个很聪明的状态机逻辑,叫等它变完。画面一变,它不急着抽,因为变化刚发生的时候,大概率抽到的是转场半途的模糊画面。它等差异分数重新跌回阈值以下,画面稳定下来,再把那一帧作为新画面的代表。只有画面一直变个不停,比如超长运镜,才会每隔1.5秒强行抽一张兜底。
这个设计,我是真的觉得,比市面上大多数抽帧工具想得深。
第二遍扫描倒是没什么花活,但有个坑值得一提。导出高清帧的时候,它没用ffmpeg自带的select滤镜,就是那个 select=eq(n,0)+eq(n,17) 的写法。为啥呢,因为关键帧一多,比如上百个,这个表达式会超出ffmpeg的参数上限直接报错。它的做法是让ffmpeg输出高质量裸流,Python侧维护一个计数器,只有命中清单里的帧号才存图。解码一遍,几百张图精准提取,内存占用还极低。
说实话,这些工程细节,外行看可能觉得没啥,但我这种踩过坑的人看到,只想说,都是血泪啊。
但以上这些,都还只是开胃菜。真正让我头皮发麻的,是最后拼总览图那块。
它会把抽出来的帧拼成总览图,方便人或者模型快速一览。注意,是方便模型。所以它的拼图规则,完全不是给人看的逻辑。
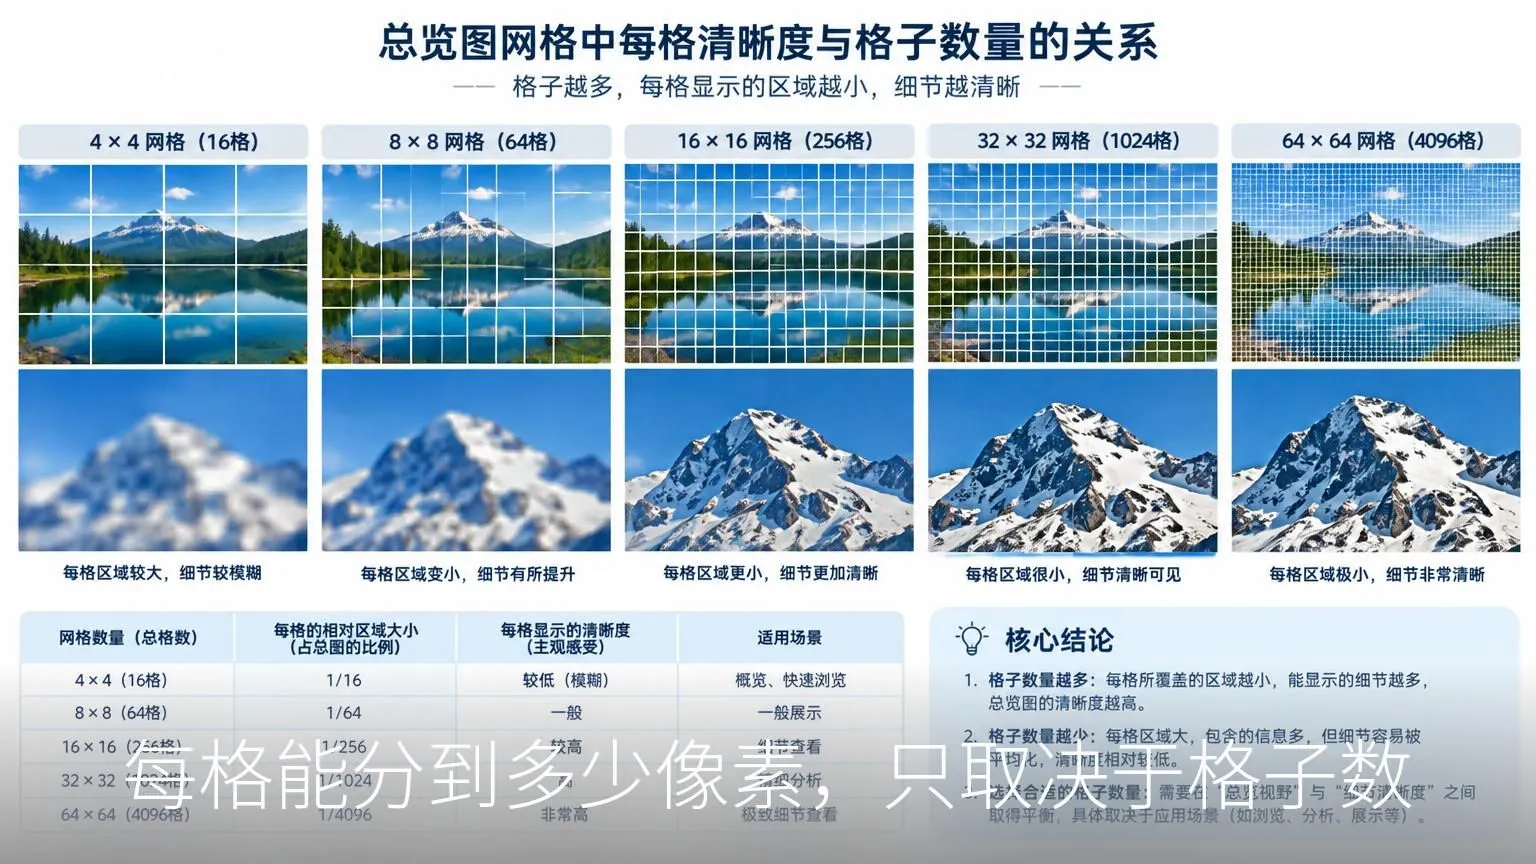
很多朋友可能不知道,多模态大模型读图是有像素预算的。它的视觉编码器会把每张图整体压缩到长边大概1080到1568像素再送进去。所以每格能分到多少像素,只取决于这张图里有多少格,跟你把图做多大,基本无关。
所以你拼一张9600像素的巨图,放40个格子,模型眼里每格只有180像素左右,糊的只剩版式和配色。而且,9597像素长边的图,会被读图工具直接拒收。
不是哥们,9597像素,直接拒收。。。
它默认的9600像素宽度,是给人放大到100%看的。给模型读,必须显式降档到1600到2400。
然后它的分张逻辑就来了。单张图最多12格,最多16格,再多就自动切分。宁可多出几张图,也绝不往一张里塞满小格,因为塞满了,模型看不清,成本还更高。它的原话是,宁可3张12格的图,不给1张塞40格的巨图。
更骚的是,它连元数据都省了。尺寸、时长、帧率,一律不印在图上,全部放进JSON里。图面上只有画面网格和每格下方的序号加时间戳,把有限的像素空间全部留给画面本身。它甚至会在本机找CJK字体,保证时间戳的中文不乱码。
这玩意儿每一个细节,都在为模型的眼睛调参。
看到这里,可能有小伙伴说,这不就是一个抽帧脚本吗,我又不搞视频处理,跟我有啥关系。
我非常理解这种感觉。说实话我自己也不是搞CV的,纯外行,一开始看这些参数也是懵的。
但这个东西背后那件事,跟每个人都有关系。
你想想看,二十年前做网站的人,得研究搜索引擎的爬虫怎么读页面,往标题里堆关键词,管这叫SEO。那是人类第一次为了一个不是人的读者,去重新设计内容的呈现方式。今天这个脚本,就是内容世界的SEO,只不过服务对象,从Google的爬虫,变成了AI的眼睛。
写到这里我忽然有点恍惚。这是我第一次见到一个软件,它的目标用户不是人。
以前的软件,UI是给人看的,字号是给人定的,清晰度是拿人的眼睛当尺子量的。而这个脚本,它的用户是GPT-4V,是Gemini,是Claude。它的像素预算,是模型的token,它的清晰度标准,是模型在1568像素的压缩下还能不能看清字幕。
我们在一间从来没有人类进去过的房子里,为一位从未谋面的访客装修。我们只知道它的解剖学参数,像素预算,token上限,上下文窗口,然后照着这些参数,一寸一寸地调整每一张图的格子数。
这种感觉,有点魔幻,又有点浪漫。
而且你想想,这件事的底层逻辑是,当内容开始被AI消费,内容的形式本身就得重新设计。过去我们排版是给人看的,现在有些内容是给模型读的,那它的呈现方式,就得按模型的视觉机制来。这个脚本只是开了个头,后面这种为AI设计的内容形式,只会越来越多。
回到这个脚本本身,它的文档里有一句话说得特别清楚。这个工具自己不下任何结论,它只负责把视频压缩成几张清晰可读的关键帧图,真正的看懂,由多模态模型完成。脚本跑完退出之后,你才会拿着它生成的overview和keyframes.json,去调你的模型。不接多模态模型,它产出的只是一堆图片,接上多模态模型,它才是一个视频理解工具。
分工分得清清楚楚。压缩与呈现,交给脚本,看懂与表达,交给模型。
所以回到我开头折腾的那件事,让AI看懂视频。现在我知道了,问题从来不在AI那一步,而在于你喂给它的东西,它到底看不看得清。脚本做完了它该做的,剩下的,交给模型。
我突然觉得,这大概就是AI时代做工具的人该有的样子。不抢模型的活,但把模型的眼睛,伺候得明明白白。
磨平一些信息差。
/ 注意,本项目仅在 SyncMein 的500人小群分享。
/ 谢谢你看完了我的文章,我们下次再见吧。
/ 作者:明察
/ 投稿或爆料,请联系邮箱:mingcha@gqmg.com



暂无评论内容