
前言:在十年前的老MacBook上折腾本地AI是什么体验?本文完整记录Chrome内置AI Gemini Nano成功运行、WebLLM却因WebGPU着色器兼容性反复失败的全过程,深入解析组件三重校验、Performance Class VeryLow评级与CPU推理降级机制,帮老设备用户看懂真实算力段位,少走弯路。
我在一台十年前的Mac上折腾本地AI,结果被Chrome上了一课
我书房里有台2015年的MacBook Pro。
Intel的,Iris核显,服役第十一年了。电池早就鼓过一次包,键盘的空格键按下去会有点粘,但它还能开机,还能打开几十个网页,我一直没舍得让它退役。
最近我突发奇想,想让这台老家伙跑跑本地AI。
不跑云端的,就要那种完全断网也能聊的,模型就躺在本机里,谁的数据都传不出去的那种。然后我就一头扎了进去,折腾了两个晚上,最后被Chrome结结实实地上了一课。
这课的名字叫,你以为的「能用」,和它以为的「能用」,根本不是一回事。
事情是从一个惊喜开始的。
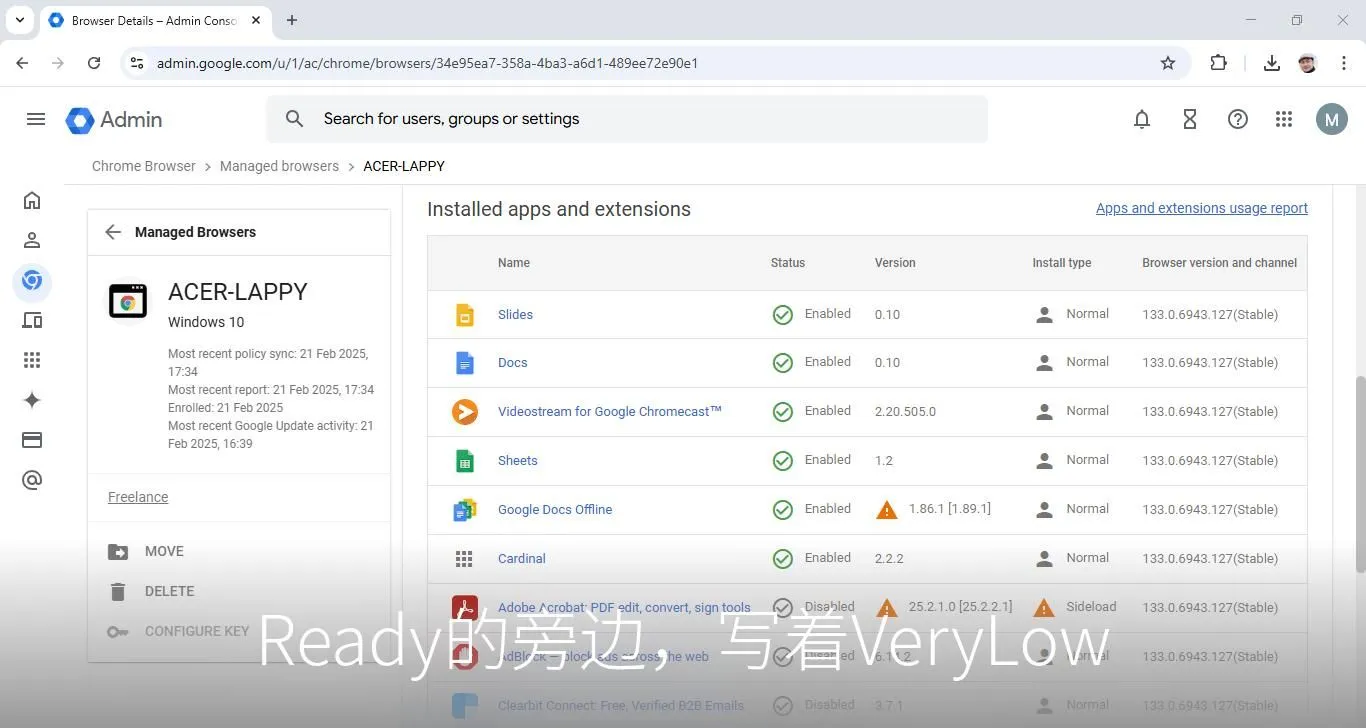
我打开Chrome的一个隐藏页面,chrome://on-device-internals,这是Chrome内置AI的「后台监控室」,能看到浏览器在本地装了什么模型、什么状态。我本来没抱什么期望,十年前的机器嘛,结果一眼扫过去,我愣了一下。
nano_v3_cpu_component,状态,Ready。
Gemini Nano,Google塞进浏览器里的那个小模型,在这台机器上,装好了,能用了。
我当时就有点兴奋。你想啊,Chrome判定一台机器能不能跑本地AI,靠的是先让GPU跑一段测试着色器,考得好就给你下大一点的模型,考不好就降级,再不行就干脆绕开GPU,直接用CPU推理。而Chrome 140之后,正式支持了CPU推理这条路。也就是说,我这台老Mac,是靠纯CPU硬扛把Nano跑起来的。
虽然慢,但它真的跑起来了。
然后我就产生了一个非常自然的推论。既然Nano都能跑,那是不是说明这台机器跑本地模型这条路是通的?市面上还有个叫WebLLM的东西,能在浏览器里直接跑大语言模型,靠的是WebGPU。我寻思,Nano都行,WebLLM应该也行吧?
于是我去装了个基于WebLLM的插件,选了个最小的降级模型,点下载,下载成功了。
然后加载。
失败。
再加载,再失败。中间还夹着一行提示,正在检测显卡着色器兼容性,每次加载都要从头检测一遍,检测完,失败,下次再来一遍。
???
就是那种感觉,明明钥匙插进锁孔了,就是拧不开。而且这锁每次还要重新验一遍你的钥匙。
我盯着屏幕看了一会儿,决定不猜了,把这事儿刨到底。
先说刨出来的第一个结论,也是整个事情里最反直觉的一个。
Nano能用,跟WebLLM能不能用,半毛钱关系都没有。
为啥?因为它俩压根是两套完全独立的栈。
Nano是Chrome原生的进程内推理,Mac上走的是CPU、神经网络引擎、Metal这一套系统级路径,它关心的是组件签名对不对、版本对不对、磁盘够不够,跟你的GPU强不强没什么关系。而WebLLM呢,它活在网页里,走的是WebGPU加WASM,它需要向浏览器要一块GPUAdapter,然后把你模型的计算逻辑编译成WGSL着色器,塞进GPU里跑。
一个考的是「系统服务通不通」,一个考的是「你的GPU能不能编译compute shader」。
这两张考卷,没有一个共同的考点。
更扎心的证据,其实一直躺在我最开始那个惊喜页面里。就在Nano Ready的同一张表上,写着两行小字,Performance Class,VeryLow。Possible Capabilities,只有Image。
翻译一下,Chrome自己给这台机器的算力评级是,极低档。能干的活,只有图像处理。
我之前压根没注意这两行。满眼都是那个绿色的Ready,自动过滤了旁边的VeryLow。这感觉就像体检报告上你只看到了「各项指标正常」,没看到角落里那行小字。
所以Nano的Ready证明的只是,Chrome的组件分发链是通的,系统级AI服务开了,浏览器版本够。它对WebLLM那条需要真GPU的路,提供不了任何担保。
好,第一个问题解了。但还有两个更具体的疑惑。
第一个,我那个降级后的模型,明明下载下来了,为什么死活装不上,状态永远停在Not Installed?
我又回到那个监控室页面仔细看。列表里有四个组件,nano_v3_cpu_component是Ready,剩下三个,gemma4、summarizer、proofreader,全是Not Installed。我一开始以为是网络问题,后来才发现,这事儿跟网络没关系。
Chrome的组件安装,是个三重门。
第一重,manifest里声明了期望的目标版本。第二重,安装时要过签名和哈希的完整性校验。第三重,服务端策略说了算。三道门全过,才会被写进「已安装」的记录里。
而我手动降级塞进去的那个版本,压根不在manifest的期望表里。它不是「装上了但没生效」,它是从头到尾就没被承认过。Chrome每次都会校验它,每次都校验不过,每次都把这次尝试记为失败然后丢弃,下次重新从CDN取。
它永远停在Not Installed,不是卡住了,是被制度性地拒绝了。
这让我想起一个特别朴素的道理,在一个有版本管理的系统里,「旧」不是一个状态,是一个错误。
第二个疑惑,也是最让我抓狂的一个。为什么每次加载,都要重新检测一遍着色器兼容性?检测过了就不能记下来吗?这机器又不会一夜之间换块显卡。
这次我直接去翻了代码。那个「正在检测显卡着色器兼容性」的提示,就写在我装的这个插件的engine.ts里,两百多行的地方。逻辑不复杂,拿一块GPU,把几段探针着色器挨个编译一遍,全过了,才写一条ok进缓存。
问题就出在「全过了才写」。
只要中间任何一段编译失败、任何一次资源拉取失败、或者结果无法判定,缓存就一个字都不写。而这么设计是有原因的,这个项目之前出过一个bug,旧版本把一种校验错误误判成「硬件不兼容」缓存了下来,导致明明能跑的模型被永久拦截。修复方案就是,只缓存明确成功的结果。
代价呢?代价就是在一台真不兼容的机器上,缓存永远不会建立。于是每次加载,都从头考一遍试。
还没完。缓存键里混着模型运行库的哈希,你一降级模型、一换运行库,缓存键直接变了,之前的记录全部作废。而且每次探测完,代码会把GPU设备销毁掉重来,页面一刷新,一切归零。更绝的是,这台老机器上GPU的标识信息经常拿不全,缓存键会退化成一个空壳子,就算某次侥幸探通了,下次的键都可能对不上。
所以你猜怎么着,每次都重新检测,不是因为缓存坏了。
是因为这台机器,从来没有一次走到过「全部成功」。
它不是记性差,它是从来没考及格过。
刨到这里,事情其实已经清楚了。我顺手又去开了个页面,chrome://gpu,想看看这台机器的WebGPU到底是什么成色。
果然,情况很不乐观。2015款的Iris核显,Chrome很可能已经悄悄把它的WebGPU回退到了SwiftShader,也就是用CPU软件模拟GPU。这种状态下有个特别坑的表象,requestAdapter能拿到设备,shader-f16也可能显示支持,一切看起来都行,但真正编译计算管线的时候会稳定失败。
也就是说,降级模型、换f32变体、换运行库,全都没用。瓶颈根本不在模型,在显卡。
折腾到这儿,两个晚上过去了,老Mac还是没能跑起WebLLM。
但我躺在床上的时候,脑子里反复过的反而是那个词,Performance Class,VeryLow。
不知道为啥,我想起了《北京折叠》。郝景芳笔下那个北京,被折成三个空间,第一空间的人享受清晨,第三空间的人只能分到夜晚。空间之间有隔断,有通行证,大多数人一辈子只能在属于自己的那一层里活动。
我们的算力,现在也在被折叠。
第一空间是M4 Max和4090,什么模型都接得住。第二空间是普通的独显,f16跑得动,大模型降降级也能玩。而第三空间,是2015年的Iris核显,是办公室里那些用了七八年的商用机,是全世界数量最庞大的那批「还够用」的电脑。
Chrome每天给每台机器跑一次着色器考试,然后安静地把它们分到各自的空间去。没有恶意,甚至初衷是好的,让每个设备都拿到自己扛得动的模型,别把老机器烧了。
但结果就是,Nano的Ready,是第三空间的通行证。它让你以为自己进了场,其实你只是被安排在了离舞台最远、但保安愿意放行的那个角落。
这话听着有点刺耳,但我不是在抱怨Chrome。恰恰相反,刨完这一圈我对它的设计反而多了点敬意。那个「只缓存明确成功」的策略,宁可让你每次重考,也不肯冒一次永久误杀的风险。这是吃过亏的代码才会长出来的谨慎。
只是站在一台十年老机器的角度,你才能看见这种谨慎的另一面。
它不给你判死刑,但它也绝不给你发通行证。它只是让你,一次,一次,又一次地,重新检测。
第二天我把这些讲给朋友听,他问我,那这台老Mac是不是就该退休了。
我想了想,说也不是。它跑Nano没问题,CPU推理嘛,慢是慢点,断网也能聊。我后来还顺手给那个插件提了个建议,探测失败别无限重试,加个计数,到上限就明明白白告诉用户,本机GPU不支持,别再让人对着转圈发呆了。
如果你也有一台老机器,也想试试本地AI,我把我踩的坑给你总结成三句话。
先去chrome://gpu看WebGPU那一段,那是你的通行证,别看别的。看到Ready别高兴太早,翻翻旁边有没有VeryLow这种小字,那才是你的真实段位。最后,别手动去动Chrome的模型目录,它校验不过会反复放弃,你越帮越忙。
至于我那台老Mac,还摆在书房里,空格键还是有点粘。
它跑不了WebLLM,但它今晚断着网,用CPU慢慢地、一个字一个字地,回了我一句话。
大时代啊,朋友们。有人在前排看烟花,有人在第三空间,用十年前的硬件,一个token一个token地,够着这个时代的边缘。
也挺浪漫的。
/ 注意,本项目仅在 SyncMein 的500人小群分享。
/ 谢谢你看完了我的文章,我们下次再见吧。
/ 作者:明察
/ 投稿或爆料,请联系邮箱:mingcha@gqmg.com


暂无评论内容